Growth Manager, CRO ou Product Owner, vous connaissez ce moment : des idées mais pas de roadmap, un backlog de 40 idées de tests, un board Jira qui déborde, et une seule question qui bloque tout : « Par où commencer ? »
Faute de temps et de développeurs disponibles, chaque test lancé prive un autre test de sa chance. Le problème, c'est que sans cadre commun, cette décision repose souvent sur l'intuition, l'urgence du moment, ou l'avis de la personne la plus convaincante en réunion. Résultat : des ressources précieuses investies sur des optimisations à faible potentiel, pendant que les vrais leviers de croissance attendent en bas de la pile.
Bei Welyft, als CRO-Agentur, ist die Priorisierung die erste Baustelle, die wir mit unseren Kunden angehen. Und seit mehreren Jahren basiert unsere Experimentierungs-Roadmap auf einem präzisen Framework: dem RICES (Reach, Impact, Confidence, Effort, Strategy). In diesem Artikel erklären wir Ihnen, wie wir es konkret anwenden, wie Sie Ihre eigenen Ideen bewerten können, und warum es nicht nur eine Formel, sondern ein echtes CRO-Governance-Tool ist.
Warum sind nicht alle Optimierungen gleich viel wert?
Eine CRO-Roadmap ist nie durch einen Mangel an Ideen begrenzt. Sie ist begrenzt durch die Zeit, die Entwicklungskapazität und die Aufmerksamkeit der Teams. Jeder Test kostet Ressourcen, sei es Konzeptionszeit, Entwicklung, QA oder einfach den Traffic, der während der Testdauer gebunden wird.
Ohne Priorisierungsmethode treten jedoch systematisch zwei Verzerrungen in den Organisationen auf, die wir begleiten:
- Der HiPPO-Bias (Highest Paid Person's Opinion): Entscheidungen werden nach der Meinung der ranghöchsten Person im Raum getroffen, nicht nach dem tatsächlichen Potenzial der Idee.
- Der Bias der Einfachheit: Teams nehmen sich die am einfachsten umzusetzenden Tests vor statt der rentabelsten, aus Bequemlichkeit oder um „Geschwindigkeit zu zeigen“.
Das Framework dient genau als Schutzmechanismus gegen diese beiden Fallstricke. Indem jeder Idee ein objektiver und gemeinsamer Score zugewiesen wird, verwandelt es eine Meinungsdebatte in eine Diskussion auf Basis gemeinsamer Kriterien. Es heißt nicht mehr „ich denke, dieser Test hat Priorität“, sondern „dieser Test erreicht 6,4, jener 4,4, und hier ist warum“.
Dieser Wechsel von der Intuition zum Scoring ermöglicht es, ein maßgeschneidertes CRO-Programm aufzubauen und die Priorisierung zu einem echten Treiber organisatorischen Werts zu machen, nicht nur zu einer Backlog-Sortierungsübung.
Die 5 Kriterien der Methode
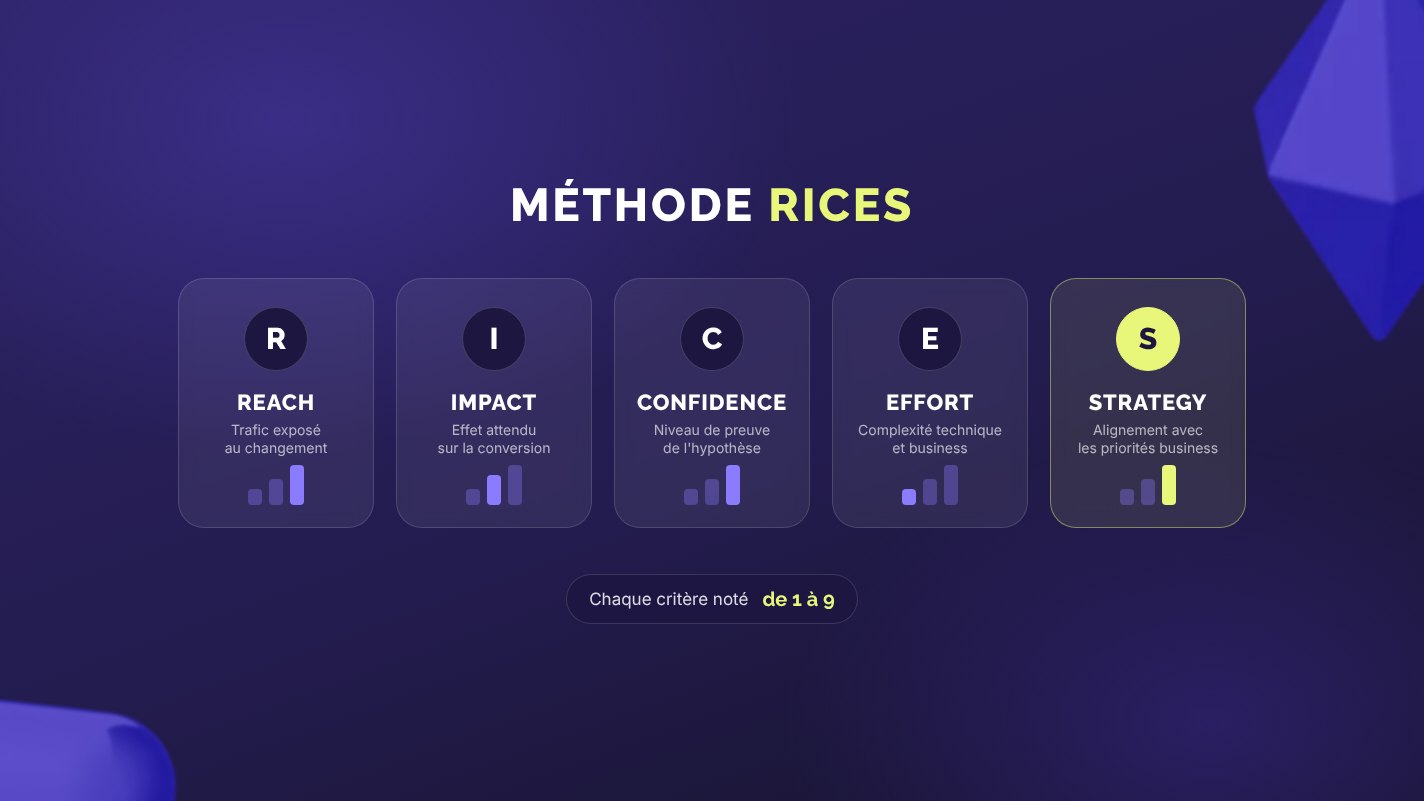
Das RICES orientiert sich am RICE-Framework, das von Growth-Teams populär gemacht wurde, und dem wir bei Welyft eine fünfte Säule hinzugefügt haben: die Strategy. Warum? Weil ein Test kurzfristig rentabel sein kann, ohne den aktuellen Geschäftsprioritäten zu dienen. Dieses fünfte Kriterium hält die Roadmap im Einklang mit der Unternehmensvision, nicht nur mit der unmittelbaren Performance.
So gliedern wir jedes der 5 Kriterien auf.
Reach: die Sichtbarkeit der Änderung
Der Reach misst das Volumen der Nutzer, die der getesteten Änderung über einen bestimmten Zeitraum (in der Regel einen Monat) ausgesetzt sind. Ein Test auf einer Produktseite, die von 100 % des Traffics gesehen wird, hat einen deutlich höheren Reach als ein Test auf einer Kundenkontoseite, die nur von einer Minderheit angemeldeter Nutzer besucht wird.
- Zu stellende Frage: Wie viele Nutzer werden diese Variation konkret sehen?
- Bei Welyft verwendete Skala: von 1 (vertrauliche Zielgruppe) bis 9 (nahezu der gesamte Traffic).
Impact: die erwartete Wirkung auf die Nutzererfahrung
Der Impact bewertet das Ausmaß der erwarteten Wirkung auf das Verhalten des exponierten Nutzers und somit auf die Conversion. Eine Änderung, die eine in der Nutzerforschung identifizierte wesentliche Friktion beseitigt, hat einen hohen Impact. Eine kosmetische Anpassung hat einen geringeren Impact, selbst wenn sie viele Menschen betrifft.
- Zu stellende Frage: Wenn diese Änderung funktioniert, wie groß wird der Gewinn beim anvisierten KPI sein?
- Bei Welyft verwendete Skala: von 1 (marginaler Effekt) bis 9 (wesentlicher Conversion-Hebel).
Confidence: der Grad der Beweise hinter der Hypothese
Die Confidence gewichtet die beiden vorherigen Kriterien entsprechend der Stabilität der Daten, die die Hypothese stützen. Ein Test, der auf einer Triangulation von Insights basiert (quantitative Daten, Verbatims, Session Replays), verdient eine hohe Confidence. Ein Test, der auf einer bloßen Intuition basiert, selbst einer brillanten, muss nach unten gewichtet werden.
- Zu stellende Frage: Worauf basiert diese Hypothese? Auf soliden Daten oder einem Gefühl?
- Bei Welyft verwendete Skala: von 1 (Intuition oder Branchen-Benchmark) bis 9 (mehrfache und übereinstimmende Beweise).
Effort: die Dualität zwischen technischer und geschäftlicher Komplexität
Der Effort fließt ebenfalls in den Score ein: Je höher der Aufwand, desto niedriger die Note, und desto stärker wirkt er sich auf das Endergebnis aus. Hier zeigt sich der eigentliche Sinn der Methode, denn der Effort beschränkt sich nicht auf den Entwicklungsaufwand. Er vereint zwei Dimensionen:
- Die technische Komplexität: Anzahl der zu ändernden Komponenten, Abhängigkeiten von anderen Teams, Infrastrukturbeschränkungen.
- Die geschäftliche Komplexität: rechtliche Validierung, Auswirkungen auf andere Kanäle, Notwendigkeit, mehrere Stakeholder vor dem Launch abzustimmen.
- Zu stellende Frage: Wie viel Zeit und Ressourcen (Entwicklung, Design, Validierung) sind tatsächlich nötig, um diesen Test umzusetzen?
- Bei Welyft verwendete Skala: von 1 (mehrwöchiges, multidisziplinäres Projekt) bis 9 (Quickwin, wenige Stunden Entwicklung).
Konkretes Beispiel: Eine Funktionsidee „teilbare Wunschliste“, die auf allen Produktseiten vorhanden ist, kann einen hohen Reach von 9 aufweisen, da sie von fast dem gesamten Traffic gesehen wird. Wenn die Umsetzung jedoch ein neues Datenbankschema, ein Benachrichtigungssystem und eine Überarbeitung mehrerer Komponenten erfordert, liegt ihr Effort bei 1 von 9. Diese technische Komplexität schmälert den Endscore direkt, trotz eines sehr hohen Sichtbarkeitspotenzials.
Strategy: die Ausrichtung an den Unternehmensprioritäten
Dies ist die Säule, die wir dem klassischen RICE hinzugefügt haben. Die Strategy misst, ob der Test einer aktuell priorisierten strategischen Ausrichtung dient: Einführung eines neuen Angebots, von der Geschäftsführung festgelegtes Quartalsziel, vorrangiger internationaler Markt usw. Ein Test, der auf dem Papier perfekt rentabel ist, aber von den Geschäftsprioritäten abgekoppelt ist, sollte im Backlog sichtbar bleiben, ohne dabei an die Spitze der Roadmap zu rücken.
- Zu stellende Frage: Dient dieser Test einem strategischen Ziel, das von der Organisation in diesem Jahr festgelegt wurde?
- Bei Welyft verwendete Skala: von 1 (keine strategische Achse) bis 9 (ausgerichtet an einer kritischen strategischen Priorität).
Wie wird der Score berechnet?
Sobald die 5 Kriterien bewertet sind, ist die Berechnung einfach: Man bildet den Durchschnitt der fünf Noten.
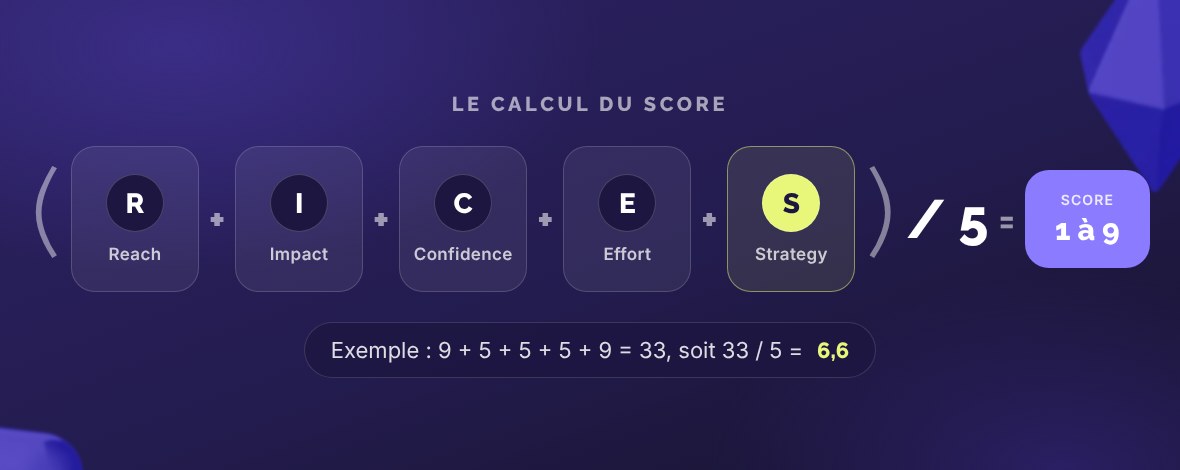
Die Regel ist klar: je höher der Score, desto höher die Priorität des Tests. Der Durchschnitt aller Kriterien stellt sicher, dass kein einzelnes Kriterium allein eine in anderen Dimensionen schwache Idee retten kann. Ein außergewöhnlicher Reach gleicht eine niedrige Confidence nicht aus. Ein minimaler Effort macht einen unbedeutenden Impact nicht wett.
Nehmen wir ein vollständiges Beispiel. Eine Testidee erhält folgende Noten: Reach = 9, Impact = 5, Confidence = 5, Effort = 5, Strategy = 9.
- 9 (Reach) + 5 (Impact) + 5 (Confidence) + 5 (Effort) + 9 (Strategy) = 33
- 33 / 5 = 6,6
Dieser Test erreicht somit einen Score von 6,6. Für sich allein bedeutet diese Zahl nichts. Erst im Vergleich mit den Scores der anderen Ideen im Backlog erhält sie ihre volle Bedeutung und ermöglicht eine objektive Entscheidung über die Reihenfolge der Roadmap.
Beispiel für Scoring bei Welyft
So wenden wir diese Formel auf ein typisches E-Commerce-Testbacklog an. Der Reiz der Tabelle besteht gerade darin, Überraschungen aufzudecken: Ideen, die in Meetings als „offensichtlich“ gelten, landen manchmal am Ende der Rangliste, während unauffällige Mikro-Optimierungen an die Spitze rücken.
| Testidee | Reach | Impact | Confidence | Effort | Strategy | Score |
|---|---|---|---|---|---|---|
| Ein Vertrauenssymbol („kostenloser Versand“) unter dem Warenkorb-CTA hinzufügen | 9 | 4 | 7 | 9 | 3 | 6,4 |
| Die Farbe des Haupt-CTA-Buttons ändern | 7 | 3 | 7 | 9 | 2 | 5,6 |
| Einen KI-gestützten Conversational Chatbot auf den Produktseiten entwickeln | 8 | 7 | 4 | 1 | 7 | 5,4 |
| Eine teilbare Wunschlisten-Funktion auf den Produktseiten hinzufügen | 8 | 4 | 5 | 1 | 4 | 4,4 |
Diese Rangliste veranschaulicht gut, warum die Methode die Reihenfolge einer Roadmap konkret verändert. Das Vertrauenssymbol, eine scheinbar geringfügige Änderung, landet an der Spitze dank eines nahezu null Effort und einer hohen Confidence (der Vertrauenshebel ist im CRO-Bereich umfassend dokumentiert). Umgekehrt landet der KI-Chatbot, oft als „großer strategischer Wurf“ wahrgenommen, weiter unten: Das Potenzial ist vorhanden, aber die Confidence bleibt gering, solange keine belastbaren Daten die Hypothese bestätigt haben, und der Effort wiegt in der Berechnung schwer.
Das bedeutet nicht, dass diese ambitionierten Tests aufgegeben werden sollten. Sie sollten zunächst entrisikiert werden, zum Beispiel durch einen Nutzertest oder einen kostengünstigen Prototyp, bevor sie zu einem vollständigen A/B test entwickelt werden. Der Score entwickelt sich dann natürlich weiter: Sobald die Confidence durch neue Insights gestärkt wird, steigt der Test automatisch in der Rangliste auf.
Eine Methode im Dienst einer ausgereiften CRO-Strategie
Über die Berechnung hinaus liegt der wahre Wert von RICES auf organisatorischer Ebene. Indem sie eine gemeinsame Sprache zwischen Growth Managern, Entwicklern, Designern und Entscheidungsträgern schafft, ermöglicht sie es, Folgendes zu erreichen:
- Eine Roadmap gegenüber den Stakeholdern zu verteidigen. Wenn ein Stakeholder fragt „Warum dieser Test vor jenem?“, basiert die Antwort nicht mehr auf einer Meinung, sondern auf einem transparenten und nachvollziehbaren Scoring.
- Implizite Abwägungen sichtbar zu machen. Das Effort-Kriterium verdeutlicht sofort die tatsächlichen Kosten einer Idee, noch bevor die Entwicklungsteams eingebunden werden.
- Eine Kultur des Nachweises schaffen. Indem die Methode die Confidence aufwertet, ermutigt sie die Teams, ihre Hypothesen mit Daten statt mit Eindrücken zu dokumentieren, was die Qualität des gesamten Experimentierprogramms verbessert.
- Den strategischen Kurs zu halten. Dank des Strategy-Kriteriums wird die Roadmap niemals zu einem bloßen Wettlauf um Punktzahlen: Sie bleibt mit den tatsächlichen Prioritäten des Unternehmens verbunden.
Bei Welyft berechnen wir die Scores bei jedem Planungszyklus neu, in der Regel alle 4 bis 6 Wochen. Ein Score ist niemals endgültig festgelegt: Sobald neue Insights eintreffen (durch ein CRO-Audit oder einen Continuous-Discovery-Ansatz), verändert sich die Confidence und damit auch die Priorität. Genau diese kontinuierliche Iteration macht daraus einen echten Roadmap-Motor und keine punktuelle Scoring-Übung.
FAQ: Ihre Fragen zur RICES-Methode
Was ist der Unterschied zwischen der RICE-Methode und der RICES-Methode?
Das klassische RICE (Reach, Impact, Confidence, Effort) wurde von Growth-Teams populär gemacht, um Produktfunktionen zu priorisieren. Bei Welyft haben wir ein fünftes Kriterium hinzugefügt, die Strategy, damit die CRO-Roadmap stets mit den aktuellen Business-Prioritäten im Einklang bleibt und nicht nur mit der reinen Rentabilität jedes einzelnen Tests.
Auf welcher Skala sollte jedes Kriterium bewertet werden?
Es gibt keine universelle Skala: Wichtig ist, von Test zu Test konsistent zu bleiben. Bei Welyft bewerten wir die Kriterien von 1 bis 9 und bilden den Durchschnitt.
Ersetzt der Score das Urteil von Experten?
Nein, er strukturiert es. Die Methode macht CRO-Expertise nicht überflüssig: Gerade die Erfahrung des Teams ermöglicht es, treffende Bewertungen zu vergeben, insbesondere bei Impact und Confidence. Das Framework dient dazu, die Diskussion zu objektivieren, nicht sie durch eine automatische Berechnung zu ersetzen.
Wie oft sollten die Scores neu berechnet werden?
Wir empfehlen, das Scoring bei jedem Roadmap-Planungszyklus zu überprüfen, also alle 4 bis 6 Wochen. Jede neue Erkenntnis, ob sie aus einem vorherigen Test, einem Nutzerinterview oder einer Datenanalyse stammt, kann die Confidence einer Idee und damit ihre Priorität verändern.
Welche Tools eignen sich für die Steuerung des Scorings?
Eine einfache Tabellenkalkulation reicht zum Start aus: eine Zeile pro Idee, eine Spalte pro Kriterium und eine automatisierte Formel für den finalen Score. Reifere Teams integrieren dieses Scoring direkt in ihr Roadmap-Management-Tool (Notion, Airtable, Jira), um es mit dem gesamten CRO-Programm zu verbinden.
Die RICES-Methode ist keine magische Formel, die an Ihrer Stelle entscheidet. Sie ist ein Werkzeug der kollektiven Disziplin, das jede Idee zwingt, ihren Wert anhand von fünf Dimensionen zu beweisen, bevor sie Ihre Entwicklungsressourcen beansprucht. Regelmäßig angewendet, verwandelt sie eine CRO-Roadmap von einer bloßen Wunschliste in ein echtes Investitionsportfolio, priorisiert nach dem tatsächlichen Wert, den es für Ihr Business schafft.