
Sie haben Ihre Analyse- und Ideenfindungsarbeit gut gemacht: Sie haben mit Ihren Kunden gesprochen, Ihre Daten durchleuchtet, sich mit verschiedenen Abteilungen ausgetauscht, um deren Insights zu erhalten. Kurz gesagt, Sie haben eine Reihe von zu optimierenden Customer Journeys, zu testenden Funktionen identifiziert, kurzum Dutzende und Aberdutzende von zu validierenden Hypothesen. Nun müssen Sie sich der Realität der Experimentierung stellen: Nicht alles kann getestet werden. Mangel an Traffic, an Entwicklungs-, Design- oder Analyseressourcen, Widerstand anderer Teams – es mangelt nicht an Gründen, einen Test aufzuschieben. Und dennoch könnten Sie sich das Leben zusätzlich zu all diesen sehr realen Hindernissen noch schwerer machen, indem Sie eine zusätzliche Einschränkung hinzufügen: immer nur einen Test gleichzeitig durchzuführen, im Namen einer vermeintlichen statistischen Reinheit, die ein Lehrbuch erröten lassen, aber die Mehrheit der Praktiker erblassen lassen würde.
Dieses Prinzip des „immer nur ein Test gleichzeitig“, das ursprünglich konzipiert wurde, um die Zuverlässigkeit der Ergebnisse zu schützen, ist in Wirklichkeit das Haupthindernis für Ihre Produktgeschwindigkeit: Wochen des Wartens für Sie und Ihre Teams, während Ihre Konkurrenten vorankommen. Bei Ihnen steht die Innovation Schlange.
Und dennoch haben die Branchenführer dieses Problem schon lange gelöst, und ihr Ansatz ist zugänglicher, als man denkt. Glauben Sie, dass die „üblichen Verdächtigen“ des digitalen Wachstums – Google, Meta, Netflix, Spotify, BlaBlaCar, Leboncoin – Hunderte, manchmal Tausende von Tests gleichzeitig laufen lassen, indem sie einen nach dem anderen angehen? Natürlich nicht. Sicherlich verfügen diese Giganten über außergewöhnliche Mittel, aber das erklärt diese Volumina nicht: Wenn man diese Anzahl an Tests auf die Teams umrechnet, die sie durchführen, stellt man fest, dass der Hebel methodisch ist, nicht budgetär. Umso mehr, als einige von ihnen, wie Google oder Netflix, über weniger Seitenvorlagen verfügen als eine E-Commerce-Website. Jede Seite muss zwangsläufig mehrere Experimente gleichzeitig tragen, da Google Search nur die Suchergebnisseite optimieren kann. Die Regel „einer nach dem anderen“ ist keine Best Practice mehr. Sie ist ein Wettbewerbsnachteil.
Die Frage ist nicht mehr, ob man seine Tests parallel laufen lassen sollte. Sie ist, wie man dies tut, ohne seine Daten oder sein Produkt zu gefährden.
1. Geschwindigkeit vs. Angst vor Kollisionen
Die geschäftliche Realität
Wenn ein isolierter Test statistisch wünschenswert ist, so ist er operativ lähmend. Jede Woche, die damit verbracht wird, auf das Ende eines Tests zu warten, bevor ein weiterer gestartet wird, ist eine verlorene Woche des Lernens. Hochgerechnet summiert sich das zu Monaten verzögerter Entscheidungen und entgangener Umsätze.
Nehmen wir ein konkretes Beispiel. Ein Produktteam mit einem Backlog von 50 Hypothesen und einem durchschnittlichen Zyklus von drei Wochen pro Test kann im sequenziellen Modus nur 17 Hypothesen pro Jahr validieren. Dasselbe Team kann mit den richtigen Schutzmaßnahmen vier- bis fünfmal mehr bewältigen, indem es parallelisiert – also das gesamte Backlog und die daraus resultierenden Iterationen. Der Unterschied ist nicht marginal: Hochgerechnet auf eine Lernrate von 60%, von denen ein Drittel gewinnende Tests sind, würde die Parallelisierung 30 zusätzliche Erkenntnisse generieren, darunter 10 zusätzliche gewinnende Tests und 20 vermiedene Verluste, wodurch sich der ROI eines Experimentierprogramms verdoppeln oder sogar verdreifachen ließe.
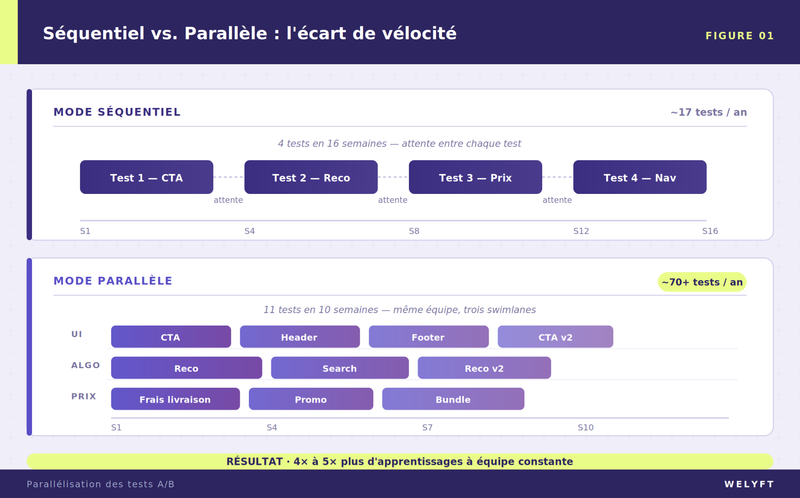
Abbildung 1: Modellierung der Geschwindigkeitsunterschiede zwischen einer sequenziellen und einer parallelisierten Roadmap
Und dieser Abstand vergrößert sich mit der Zeit. Teams, die schneller testen, lernen schneller. Die, die schneller lernen, iterieren schneller. Und die, die schneller iterieren, erobern einen überproportionalen Anteil des Werts auf ihrem Markt. Das ist nicht theoretisch: Es ist ein kumulativer Effekt, den man bei jedem digitalen Marktführer beobachtet, der paralleles Testing zur Standardpraxis gemacht hat.
Warum isolieren? Die Angst vor Interaktionseffekten
Seien wir ehrlich: Interaktionseffekte existieren. Wenn Sie gleichzeitig eine rote Schaltfläche und einen roten Hintergrund testen, riskieren Sie, Ihre Benutzeroberfläche für einen Teil Ihres Publikums unleserlich zu machen und beide Tests zu entwerten. Diese Art von direktem Konflikt zwischen zwei Tests, den man als antagonistische Interaktionen bezeichnet, kann zu beeinträchtigten Nutzererfahrungen und zu Produktentscheidungen führen, die auf verfälschten Daten basieren.
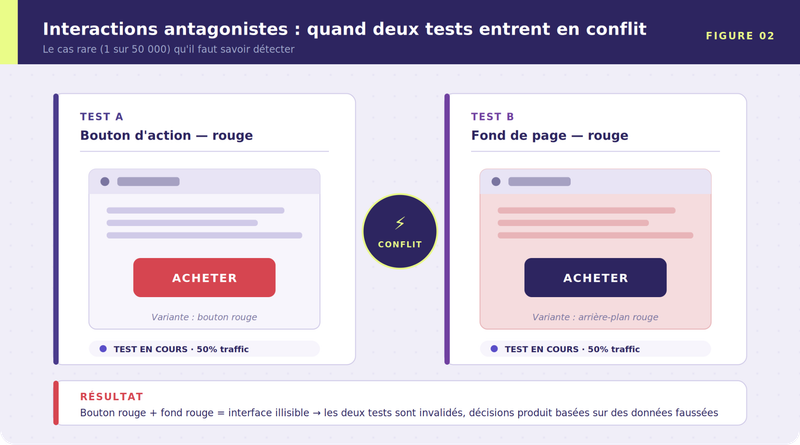
Abbildung 2: Darstellung antagonistischer Interaktionen zwischen zwei parallelisierten Tests auf demselben Element
Die Realität ist jedoch, dass die überwältigende Mehrheit der Interaktionen zwischen Tests nicht existiert und noch weniger signifikant ist. Eine Studie des Experimentierteams von Microsoft (Kohavi et al.), die Hunderttausende von gleichzeitigen Testpaaren auf Bing und Microsoft-Produkten analysierte, hat gezeigt, dass Interaktionen, die groß genug sind, um eine Produktionsentscheidung zu verfälschen, nur in 1 von 50.000 Fällen auftreten.
Einer von fünfzigtausend.
Diese Seltenheit lässt sich einfach erklären: Es ist bereits selten, einen statistisch signifikanten Effekt zu erkennen, wenn ein Test allein läuft (Spotify gibt Lernraten von 64% an). Es ist also noch seltener, dass zwei Tests gleichzeitig ein signifikantes Ergebnis liefern, und noch seltener, dass dieses Phänomen eine Produktionsentscheidung umkehrt. Dennoch kann in den seltenen Fällen, in denen starke Interaktionen bestehen und nicht überwacht werden, die Wahrscheinlichkeit, die falsche Variante zu wählen, auf bis zu etwa ein Drittel der Fälle ansteigen.
Die Antwort ist also nicht blindes Vertrauen. Es geht darum, eine Architektur und eine Governance zu etablieren, die diese Parallelisierung orchestrieren, um Interaktionen zu erkennen, wenn es sie gibt, und aus ihnen zu lernen.
2. Wie parallelisiert man wie die renommiertesten CRO-Programme?
Die Architektur in Ebenen: eine Roadmap mit Swimlanes
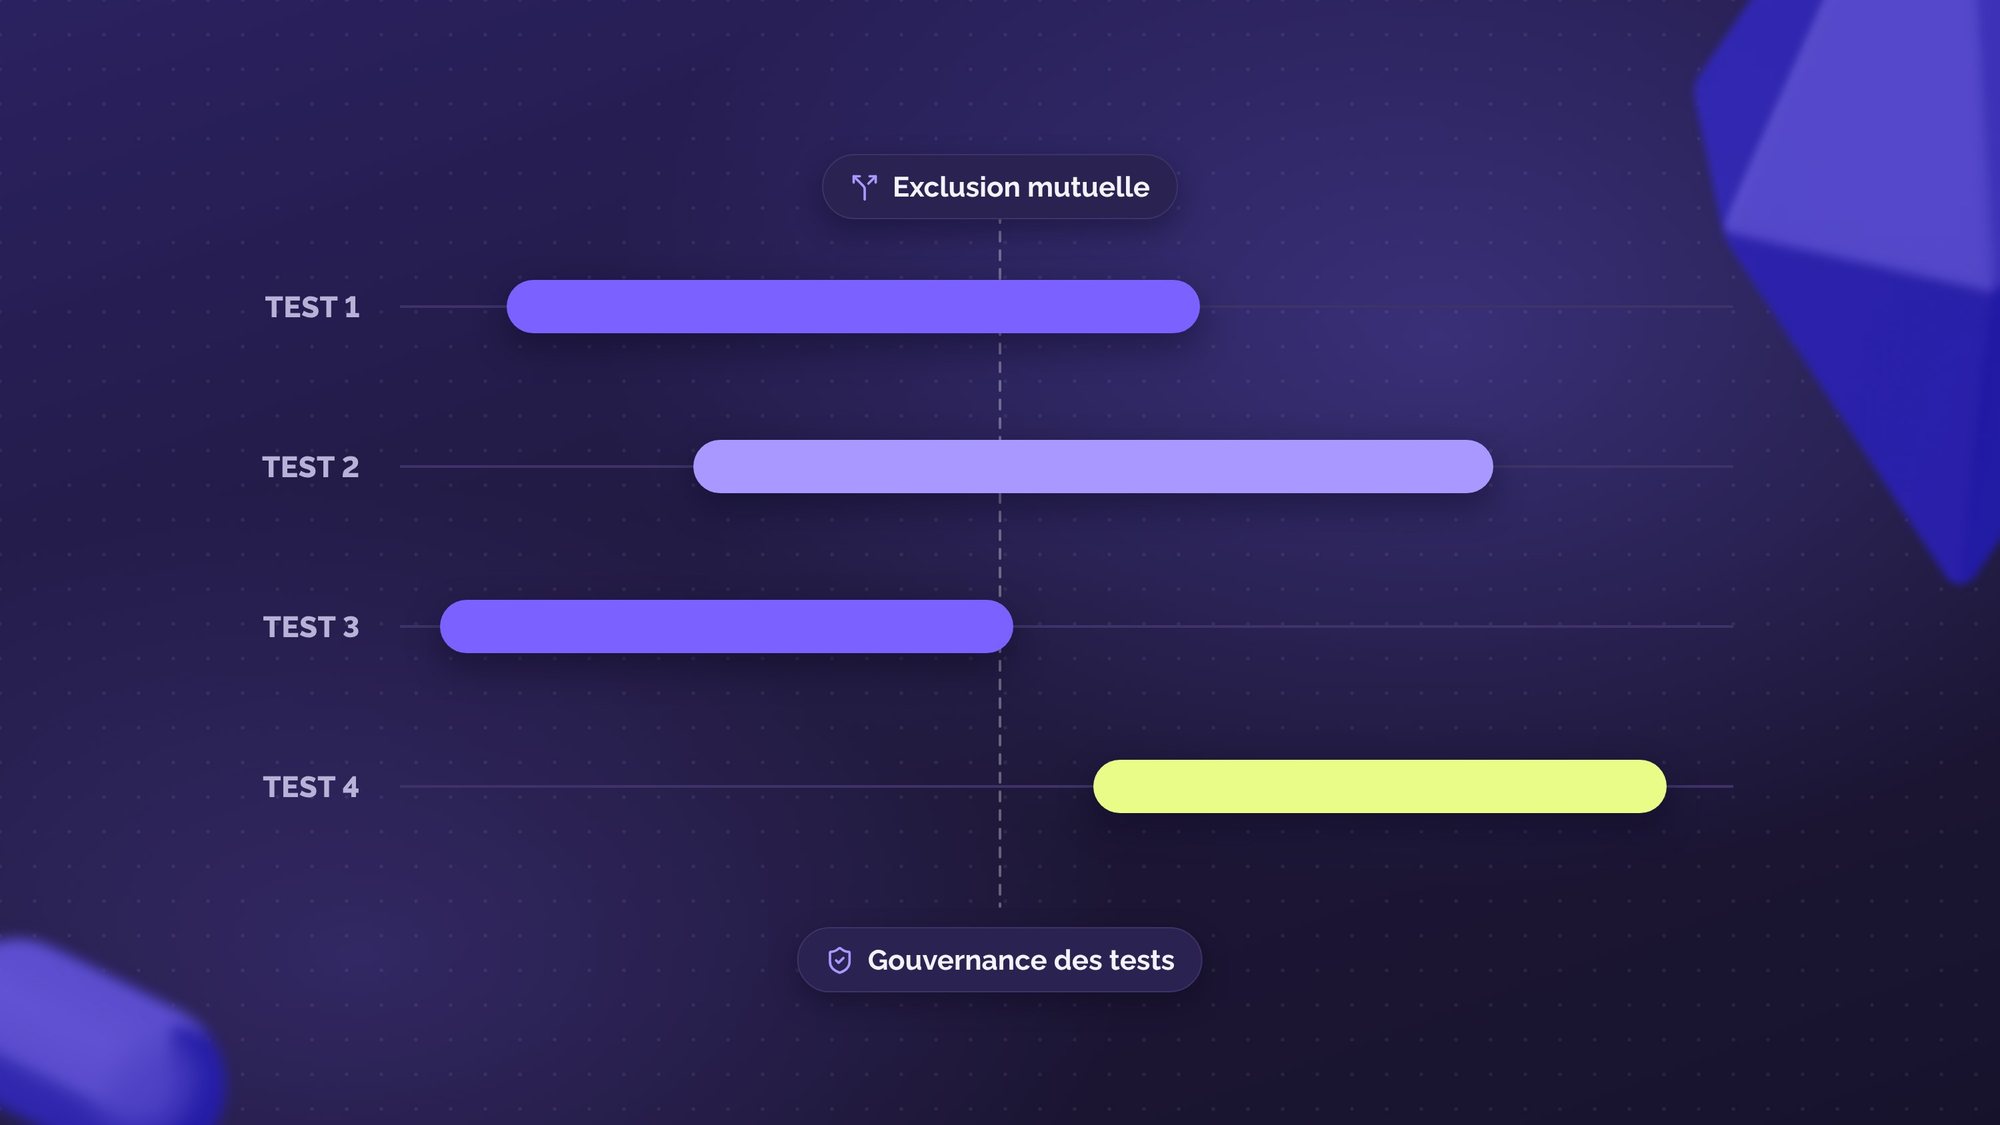
Der erste Reflex, um sicher zu parallelisieren, ist einfach und erfordert kein ausgeklügeltes Tool: Trennen Sie Ihre Tests manuell nach Geltungsbereich und Element, genau so, wie Sie eine Produkt-Roadmap mit Swimlanes organisieren würden. Jede Spur repräsentiert einen eigenen Geltungsbereich und ermöglicht ein Minimum an Interaktion, ohne die Geschwindigkeit zu opfern. Im Laufe seiner Reise kann ein Nutzer von einer Spur zur anderen wechseln und somit von einem Test zum anderen. Und wie wir gesehen haben, ist das kein Problem: Wichtig ist, sicherzustellen, dass man nicht in einen der seltenen Fälle gerät, in denen ein Test die Interpretation der Ergebnisse eines anderen verfälscht.

Abbildung 3: Eine Roadmap mit unterschiedlichen Ebenen zwischen Seiten und Elementen, um die Parallelisierung zu strukturieren
Bei Welyft empfehlen wir oft, zunächst eine erste Ebene von Spuren basierend auf den Seiten- oder Bildschirmvorlagen zu modellieren, um die Etappen des Parcours zu unterscheiden, die jeweils eigene Herausforderungen haben. Wenn die Geschwindigkeit es erfordert, kann man anschließend eine zweite Ebene mit einer freieren Aufteilung hinzufügen: nach Element, nach Art der Änderung (UI, algorithmisch, Pricing usw.) oder nach Nutzersegment. Solange zwei Experimente nicht denselben Geltungsbereich betreffen, können sie parallel laufen, ohne Interferenzrisiko.
Diese Logik funktioniert, sobald Ihre Tests unterschiedliche Elemente betreffen. Wenn Sie hingegen die Interaktionen zwischen mehreren Elementen derselben Seite messen möchten, können Sie auf einen multivariaten Test (MVT) zurückgreifen. Es genügt, dies in Ihrer Roadmap zu kennzeichnen, indem derselbe Test gleichzeitig in mehreren Spuren erscheint.
Auf einer E-Commerce-Plattform bedeutet das konkret: Ein Nutzer kann gleichzeitig an einem Test zum Wording des Lieferschritts, an einem Test der Empfehlungs-Engine und an einem MVT teilnehmen, der die Interaktionen zwischen dem CTA „In den Warenkorb“, der Position der Bewertungen und dem Layout der Produktbilder auf der Produktseite misst, ohne jede Kollision, weil jedes Experiment seiner eigenen Spur in der Roadmap zugewiesen ist.
Die Logik der Swimlanes beruht auf einer impliziten Annahme: Was Sie mit einem Nutzer tun, beeinflusst die anderen nicht. In einem Marketplace (VTC, Essenslieferung, Dienstleistungsplattformen) bricht diese Annahme zusammen, da das Angebot geteilt wird. Wenn ein Test die Bestellungen auf der Nachfrageseite erhöht, beanspruchen diese Bestellungen Fahrer, die der Kontrollgruppe gedient hätten: Die beiden Gruppen interagieren, und das beobachtete Ergebnis überschätzt den tatsächlichen Effekt. Zu den Interaktionen zwischen Tests kommt also eine zweite Familie von Interaktionen hinzu, zwischen Nutzertypen, die Swimlanes nicht abdecken. Um sie zu beherrschen, müssen bereits in der Roadmap dedizierte Techniken wie die Cluster-Randomisierung (Isolation nach geografischer Zone) oder das Switchback-Testing (abwechselnde Behandlungen über die Zeit) integriert werden.
Automatisierung als Sicherheitsnetz
Diese manuelle Organisation reicht für die große Mehrheit der Programme aus. Aber wenn das Testvolumen explodiert, wird menschliches Versagen zur Hauptgefahr, und genau da kommt die Automatisierung ins Spiel.
Die erste Automatisierungsebene, die allen Teams zugänglich ist, besteht darin, automatische Prüfungen auf den aktiven Tests laufen zu lassen: tägliche Jobs bewerten alle laufenden Testpaare und melden signifikante Interaktionen. Der seltene Fall von 1 auf 50.000 wird erkannt; der Rest läuft frei. Die Haltung ist klar: standardmäßig parallelisieren, kontinuierlich überwachen, nur isolieren, wenn die Daten es erfordern.
Für Programme mit sehr hohem Volumen ist eine zweite Ebene möglich: die Architektur der Roadmap selbst mit technischen Mechanismen formalisieren (unterschiedliche Hash-Salts pro Ebene, unabhängige Nutzerzuweisung), was die Isolation durch Konstruktion garantiert. Aber für die große Mehrheit der Teams rechtfertigt sich dieses Investitionsniveau nicht – eine gut organisierte Roadmap mit Swimlanes genügt, um den Großteil der Geschwindigkeitsgewinne zu erzielen.
3. Warum die Technik nicht ausreicht?
Alles, was wir gerade gesehen haben, Swimlanes, MVT, Automatisierung, ist technisch zugänglich. Und dennoch schaffen es nur sehr wenige Organisationen tatsächlich. Warum? Weil der wahre Engpass niemals das Tool ist. Es ist alles, was drumherum existieren muss.
Das eigentliche Problem ist organisatorisch
Wenn mehrere Teams parallel Tests starten können, muss jemand die Spielregeln besitzen. Wer darf was auf welcher Ebene testen? Was stellt einen gültigen KPI dar? Wann ist ein Test ausreichend ausgereift, um abgeschlossen zu werden? Wer entscheidet, wenn zwei Tests dasselbe Segment anvisieren? Die Automatisierung wendet Regeln an, sie schreibt sie nicht. Ohne klare Governance erzeugt die Parallelisierung Verwirrung, keinen Wert.
Vertrauen als Motor des Wandels
Und selbst mit klaren Regeln bleibt ein heimtückischeres Hindernis: diese Regeln akzeptiert zu bekommen. Senior-Entscheider, die ihr Gespür anhand isolierter Ergebnisse aufgebaut haben, werden Schlussfolgerungen aus parallelisierten Tests oft ablehnen, insbesondere ungünstige Schlussfolgerungen, eher aus Reflex als aus Analyse. „Diese Ergebnisse sind nicht verlässlich, es liefen andere Tests gleichzeitig“ wird zu einem bequemen Argument, um unangenehme Daten zu ignorieren.
Genau das muss Governance leisten: institutionelles Vertrauen in den methodischen Rahmen aufzubauen ist genauso wichtig wie den Rahmen selbst zu schaffen. Das gelingt durch Vermittlungsarbeit, reproduzierbare Ergebnisse und vollständige Transparenz über die Methodik – nicht durch ein weiteres Slide Deck im Führungsausschuss.
Die Bedeutung dedizierter Expertise
Die Governance zu besitzen und dieses Vertrauen aufzubauen, ist ein eigenständiger Beruf. Organisationen, die ihre parallelen Experimentierprogramme skalieren, teilen alle ein gemeinsames Merkmal: eine dedizierte Funktion, die die Methodologie, die Governance-Regeln und die Kompetenzentwicklung der Teams besitzt. Bei Google oder Netflix ist das eine Armee interner Spezialisten – ein Luxus, der für die meisten französischen und europäischen Unternehmen weder realistisch noch wirtschaftlich sinnvoll ist.
Welyft strukturiert und beschleunigt die Programme seiner Kunden, um ein Maximum an Erkenntnissen zu liefern, ohne jemals die Zuverlässigkeit der Ergebnisse zu gefährden – von der Testarchitektur über die Programm-Governance bis hin zur Schulung der Entscheidungsträger.
Werden Sie aktiv
A/B-Tests zu parallelisieren ist kein gewagtes Unterfangen, das nur den Tech-Giganten mit Millionen täglichen Nutzern vorbehalten ist. Es ist der operative Standard für jedes ernsthafte digitale Team auf Wachstumskurs.
Die eigentliche Herausforderung ist nicht statistischer Natur; die Microsoft-Studie und die Praktiken der größten Experimentatoren belegen dies. Sie ist organisatorisch. Teams, die sich aus Angst vor Interaktionen einschränken, scheitern nicht, weil sich diese Befürchtungen bewahrheitet haben. Sie scheitern, weil niemand die Governance besaß und niemand das nötige Vertrauen aufgebaut hatte, um auf Ergebnisse zu reagieren, die nicht „sauber“ erscheinen.
Genau diese Art von statistischer, technischer und organisatorischer Herausforderung begleitet Welyft täglich bei französischen und europäischen digitalen Teams. Von der Experimentierarchitektur über die Programm-Governance bis hin zur Schulung der Entscheidungsträger ist unser Ansatz auf die Realitäten Ihres Marktes zugeschnitten, DSGVO inklusive.
Möchten Sie sich vor dem Start weiter vertiefen? Wir haben eine umfassende Übersicht über statistische Rahmenwerke, Architekturen und Praktiken der weltweit besten Experimentierteams zusammengestellt – ein konkreter Leitfaden, um Ihren eigenen Ansatz zu strukturieren.