Growth Manager, CRO-specialist of Product Owner, je kent dit moment: genoeg ideeën maar geen roadmap, een backlog van 40 testideeën, een overvol Jira-board, en één vraag die alles blokkeert: "Waar beginnen we?"
Door gebrek aan tijd en beschikbare developers ontneemt elke gelanceerde test een andere test zijn kans. Het probleem is dat deze beslissing zonder gezamenlijk kader vaak berust op intuïtie, de urgentie van het moment, of de mening van de meest overtuigende persoon in de vergadering. Het resultaat: kostbare middelen worden geïnvesteerd in optimalisaties met weinig potentieel, terwijl de echte groeihefbomen onderaan de stapel blijven liggen.
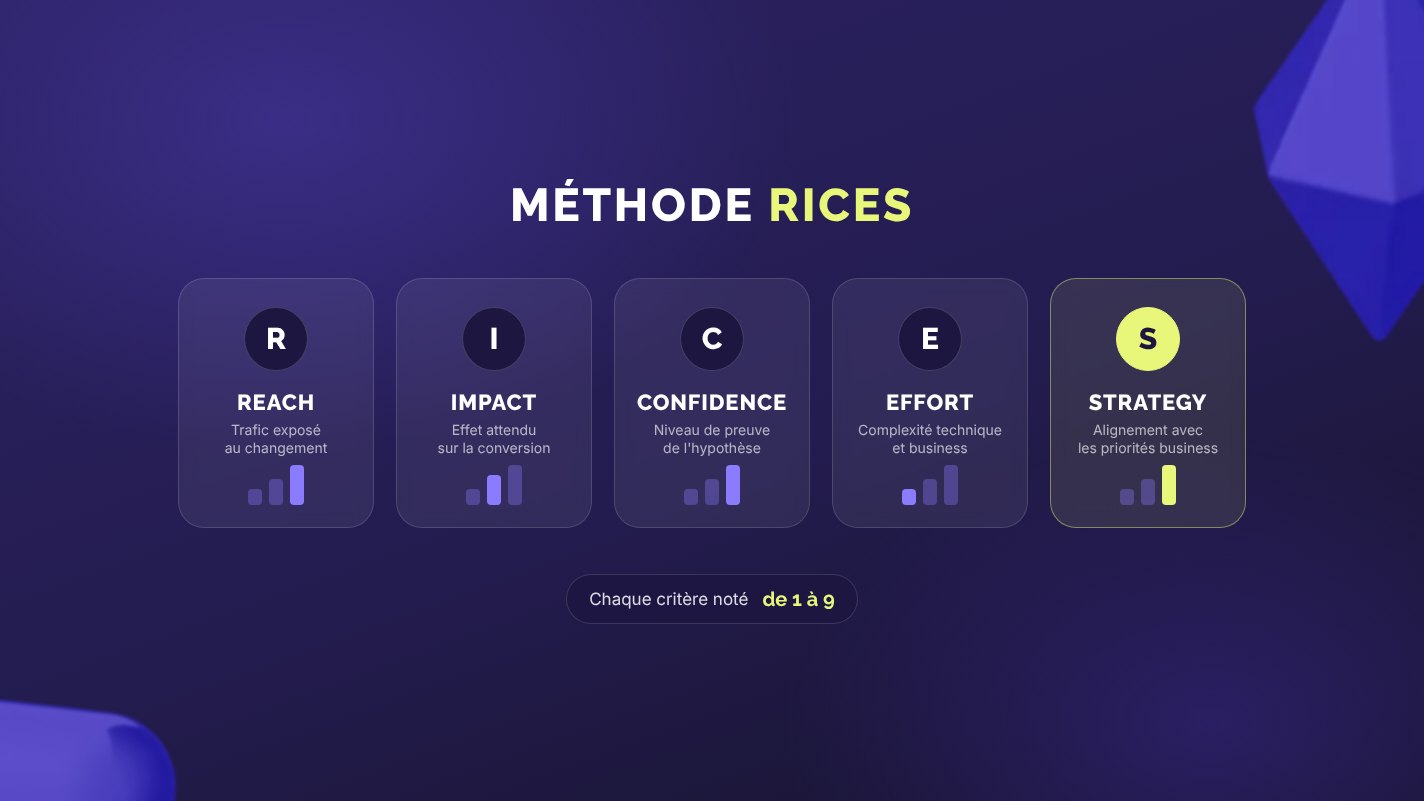
Bij Welyft, als CRO-bureau, is prioritering het eerste traject dat we met onze klanten opstarten. En al jarenlang baseren we onze experimentatieroadmap op een precies framework: het RICES (Reach, Impact, Confidence, Effort, Strategy). In dit artikel leggen we je uit hoe we dit concreet toepassen, hoe je je eigen ideeën kunt scoren, en waarom dit niet zomaar een formule is, maar een echt CRO-governance-instrument.
Waarom zijn niet alle optimalisaties evenveel waard?
Een CRO-roadmap wordt nooit beperkt door een gebrek aan ideeën. Ze wordt beperkt door tijd, ontwikkelcapaciteit en de aandacht van teams. Elke test kost middelen, of het nu gaat om ontwerptijd, ontwikkeling, QA of simpelweg de verkeer die tijdens de testduur wordt ingezet.
Zonder prioriteringsmethode komen er systematisch twee bias terug bij de organisaties die we begeleiden:
- De HiPPO-bias (Highest Paid Person's Opinion): beslissingen worden genomen op basis van de mening van de hoogstgeplaatste persoon in de kamer, niet op basis van het werkelijke potentieel van het idee.
- De gemakzucht-bias: teams pakken de eenvoudigst te ontwikkelen tests aan in plaats van de meest winstgevende, uit comfort of om "snelheid te tonen".
Het framework dient juist als waarborg tegen deze twee valkuilen. Door elk idee een objectieve, gedeelde score toe te kennen, verandert het een meningsdiscussie in een gesprek op basis van gemeenschappelijke criteria. Het is niet langer 'ik denk dat deze test prioriteit heeft', maar 'deze test scoort 6,4, die andere 4,4, en dit is waarom'.
Het is die omslag, van intuïtie naar scoring, die het mogelijk maakt om een op maat gemaakt CRO-programma op te bouwen en van prioritering een echte bron van organisatorische waarde te maken, niet alleen een backlog-sorteeroefening.
De 5 criteria van de methode
RICES is geïnspireerd op het RICE-framework dat populair werd gemaakt door growth-teams, waaraan we bij Welyft een vijfde pijler hebben toegevoegd: Strategy. Waarom? Omdat een test op korte termijn winstgevend kan zijn zonder de huidige businessprioriteiten te dienen. Dit vijfde criterium houdt de roadmap afgestemd op de visie van het bedrijf, niet alleen op directe performance.
Zo splitsen we elk van de 5 criteria op.
Reach: de zichtbaarheid van de verandering
Reach meet het aantal gebruikers dat binnen een bepaalde periode (meestal een maand) wordt blootgesteld aan de geteste wijziging. Een test op een productpagina, gezien door 100% van het verkeer, zal een veel hogere Reach hebben dan een test op een klantaccountpagina, bezocht door een minderheid van ingelogde gebruikers.
- Vraag die je jezelf moet stellen: hoeveel gebruikers zullen deze variant daadwerkelijk zien?
- Schaal gebruikt bij Welyft: van 1 (beperkte doelgroep) tot 9 (nagenoeg al het verkeer).
Impact: het verwachte effect op de gebruikerservaring
Impact beoordeelt de omvang van het verwachte effect op het gedrag van de blootgestelde gebruiker, en dus op de conversie. Een verandering die een belangrijke frictie opheft die in gebruikersonderzoek is geïdentificeerd, heeft een hoge Impact. Een cosmetische aanpassing heeft een lagere Impact, zelfs als deze veel mensen bereikt.
- Vraag die je jezelf moet stellen: als deze verandering werkt, hoe groot zal de winst op de beoogde KPI zijn?
- Schaal gebruikt bij Welyft: van 1 (marginaal effect) tot 9 (belangrijke conversiehefboom).
Confidence: het bewijsniveau achter de hypothese
Confidence weegt de twee voorgaande criteria op basis van de stevigheid van de data die de hypothese onderbouwen. Een test die gebaseerd is op een triangulatie van inzichten (kwantitatieve data, verbatims, sessierecordings) verdient een hoge Confidence. Een test die enkel op intuïtie berust, hoe briljant ook, moet lager worden gewogen.
- Vraag die je jezelf moet stellen: waarop is deze hypothese gebaseerd? Op solide data, of op een gevoel?
- Schaal gebruikt bij Welyft: van 1 (intuïtie of sectorbenchmark) tot 9 (meerdere en overeenstemmende bewijzen).
Effort: de dualiteit tussen technische en business-complexiteit
Effort maakt ook deel uit van de score: hoe groter de inspanning, hoe lager de score, en hoe meer dit het eindresultaat beïnvloedt. Hier krijgt de methode pas echt betekenis, want Effort beperkt zich niet tot de ontwikkelingslast. Het combineert twee dimensies:
- De technische complexiteit: aantal te wijzigen componenten, afhankelijkheden met andere teams, infrastructuurbeperkingen.
- De business-complexiteit: juridische validatie, impact op andere kanalen, noodzaak om meerdere stakeholders af te stemmen voordat je lanceert.
- Vraag die je jezelf moet stellen: hoeveel tijd en middelen (dev, design, validatie) zijn er werkelijk nodig om deze test te leveren?
- Schaal gebruikt bij Welyft: van 1 (multidisciplinair project van meerdere weken) tot 9 (quickwin, enkele uren ontwikkeling).
Concreet voorbeeld: een functie-idee als een 'deelbare wishlist' op alle productpagina's kan een hoge Reach van 9 krijgen, omdat het door vrijwel al het verkeer wordt gezien. Maar als de implementatie een nieuw databaseschema, een notificatiesysteem en de herziening van meerdere componenten vereist, zal de Effort slechts 1 op 9 zijn. Deze technische complexiteit drukt de eindscore direct naar beneden, ondanks een zeer hoog zichtbaarheidspotentieel.
Strategy: afstemming met de bedrijfsprioriteiten
Dit is de pijler die we hebben toegevoegd aan het klassieke RICE. Strategy meet of de test bijdraagt aan een actuele strategische prioriteit: de lancering van een nieuw aanbod, een kwartaaldoelstelling van het management, een prioritaire internationale markt, enzovoort. Een test die op papier perfect winstgevend is, maar losstaat van de businessprioriteiten, moet zichtbaar blijven in de backlog zonder bovenaan de roadmap te komen.
- Vraag die je jezelf moet stellen: draagt deze test bij aan een strategisch doel dat de organisatie dit jaar heeft vastgesteld?
- Schaal gebruikt bij Welyft: van 1 (geen strategische prioriteit) tot 9 (afgestemd op een kritieke strategische prioriteit).
Hoe bereken je de score?
Zodra de 5 criteria zijn gescoord, is de berekening eenvoudig: je neemt het gemiddelde van de vijf scores.
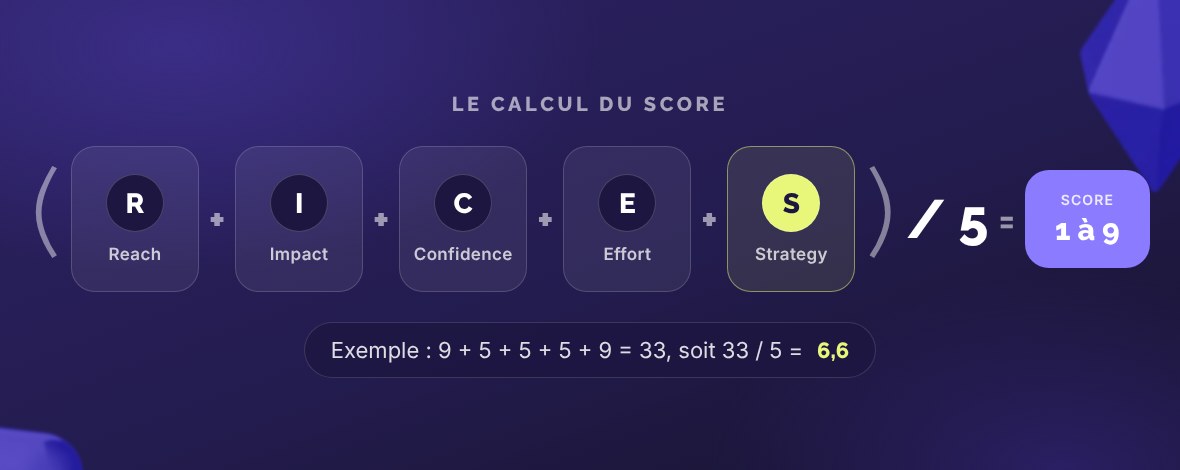
De regel is duidelijk: hoe hoger de score, hoe hoger de prioriteit van de test. Door het gemiddelde van alle criteria te nemen, zorg je ervoor dat geen enkel criterium op zichzelf een idee kan redden dat zwak scoort op de andere dimensies. Een uitzonderlijke Reach compenseert geen lage Confidence. Een minimale Effort haalt geen onbeduidende Impact in.
Laten we een volledig voorbeeld bekijken. Een testidee krijgt de volgende scores: Reach = 9, Impact = 5, Confidence = 5, Effort = 5, Strategy = 9.
- 9 (Reach) + 5 (Impact) + 5 (Confidence) + 5 (Effort) + 9 (Strategy) = 33
- 33 / 5 = 6,6
Deze test krijgt dus een score van 6,6. Op zichzelf zegt dit cijfer niets. Pas door het te vergelijken met de scores van de andere ideeën in de backlog krijgt het betekenis en kun je objectief de volgorde van de roadmap bepalen.
Voorbeeld van scoring bij Welyft
Zo passen we deze formule toe op een testbacklog van een typische e-commerceomgeving. Het interessante aan de tabel is dat die juist verrassingen aan het licht brengt: ideeën die in een meeting "vanzelfsprekend" leken, belanden soms onderaan de ranglijst, terwijl onopvallende micro-optimalisaties naar de top stijgen.
| Testidee | Reach | Impact | Confidence | Effort | Strategy | Score |
|---|---|---|---|---|---|---|
| Een geruststellend badge toevoegen ("gratis verzending") onder de CTA van de winkelwagen | 9 | 4 | 7 | 9 | 3 | 6,4 |
| De kleur van de belangrijkste CTA-knop wijzigen | 7 | 3 | 7 | 9 | 2 | 5,6 |
| Een conversationele AI-chatbot ontwikkelen op productpagina's | 8 | 7 | 4 | 1 | 7 | 5,4 |
| Een deelbare verlanglijstfunctie toevoegen op productpagina's | 8 | 4 | 5 | 1 | 4 | 4,4 |
Deze ranglijst laat goed zien waarom de methode de volgorde van een roadmap concreet verandert. Het geruststellende badge, op het eerste gezicht een kleine aanpassing, komt bovenaan te staan dankzij een vrijwel nihil Effort en een sterke Confidence (het effect van geruststelling is in CRO uitgebreid gedocumenteerd). De AI-chatbot daarentegen, vaak gezien als een "grote strategische gok", eindigt lager: het potentieel is er, maar de Confidence blijft laag zolang geen solide data de hypothese heeft bevestigd, en het Effort weegt zwaar door in de berekening.
Dit betekent niet dat deze ambitieuze tests moeten worden opgegeven. Ze moeten eerst gederisikeerd worden, bijvoorbeeld via een gebruikerstest of een goedkoop prototype, voordat ze worden uitgewerkt tot een volledige A/B test. De score verandert dan vanzelf: zodra de Confidence versterkt wordt door nieuwe inzichten, stijgt de test automatisch in de ranglijst.
Een methode die een volwassen CRO-strategie ondersteunt
Naast de berekening zelf schuilt de echte waarde van RICES in de organisatie. Door een gemeenschappelijke taal op te leggen tussen Growth Managers, developers, designers en beslissers, maakt het mogelijk om:
- Een roadmap te verdedigen tegenover stakeholders. Wanneer een stakeholder vraagt 'waarom deze test vóór die andere?', berust het antwoord niet langer op een mening, maar op een transparante en reproduceerbare scoring.
- Impliciete afwegingen zichtbaar te maken. Het Effort-criterium herinnert meteen aan de werkelijke kosten van een idee, nog vóórdat de ontwikkelteams worden ingeschakeld.
- Een cultuur van bewijs te creëren. Door Confidence te benadrukken, moedigt de methode teams aan om hun hypothesen te onderbouwen met data in plaats van met aannames, wat de kwaliteit van het hele experimentatieprogramma verbetert.
- De strategische koers aan te houden. Dankzij het Strategy-criterium wordt de roadmap nooit een simpele race naar de hoogste score: hij blijft verbonden met de werkelijke prioriteiten van het bedrijf.
Bij Welyft herberekenen we de scores bij elke planningscyclus, meestal elke 4 tot 6 weken. Een score staat nooit vast: naarmate nieuwe inzichten binnenkomen (via een CRO-audit of een Continuous Discovery-aanpak), verandert de Confidence, en dus ook de prioriteit. Het is deze voortdurende iteratie die er een echte motor van de roadmap van maakt, en geen eenmalige scoring-oefening.
FAQ: je vragen over de RICES-methode
Wat is het verschil tussen de RICE-methode en de RICES-methode?
De klassieke RICE-methode (Reach, Impact, Confidence, Effort) werd populair gemaakt door growthteams om productfuncties te prioriteren. Bij Welyft hebben we een vijfde criterium toegevoegd, Strategy, zodat de CRO-roadmap altijd aansluit bij de actuele businessprioriteiten, en niet alleen bij de brutowinstgevendheid van elke test.
Op welke schaal moet je elk criterium beoordelen?
Er bestaat geen universele schaal: het belangrijkste is consistentie van test tot test. Bij Welyft beoordelen we de criteria van 1 tot 9 en berekenen we het gemiddelde.
Vervangt de score het oordeel van een expert?
Nee, het structureert dat oordeel juist. De methode maakt CRO-expertise niet overbodig: het is precies de ervaring van het team die het mogelijk maakt om juiste scores toe te kennen, met name voor Impact en Confidence. Het framework dient om de discussie te objectiveren, niet om die te vervangen door een automatische berekening.
Hoe vaak moeten de scores opnieuw berekend worden?
We raden aan om de scoring te herzien bij elke roadmapplanningscyclus, dus elke 4 tot 6 weken. Elk nieuw inzicht, of dit nu komt uit een vorige test, een gebruikersinterview of een data-analyse, kan de Confidence van een idee en dus de prioriteit ervan laten veranderen.
Welke tools gebruik je om je scoring te beheren?
Een eenvoudig spreadsheet volstaat om te beginnen: één rij per idee, één kolom per criterium, en een geautomatiseerde formule voor de eindscore. Meer volwassen teams integreren deze scoring direct in hun roadmaptool (Notion, Airtable, Jira) om deze te koppelen aan het volledige CRO-programma.
De RICES-methode is geen toverformule die voor jou beslist. Het is een instrument voor collectieve discipline, dat elk idee dwingt zijn waarde op vijf dimensies te bewijzen voordat het jouw ontwikkelcapaciteit inzet. Consequent toegepast, verandert het een CRO-roadmap van een simpele wensenlijst in een echte investeringsportefeuille, geprioriteerd op basis van de waarde die het daadwerkelijk voor jouw business creëert.