
Je hebt je analyse- en ideatiewerk goed gedaan: je hebt met je klanten gesproken, je data ontleed, met verschillende afdelingen overlegd om hun inzichten te verzamelen. Kortom, je hebt een reeks paden geïdentificeerd die geoptimaliseerd kunnen worden, functionaliteiten die getest moeten worden, kortom tientallen en tientallen hypotheses om te valideren. Nu moet je de realiteit van experimenteren onder ogen zien: niet alles kan getest worden. Gebrek aan traffic, ontwikkel-, design- of analysecapaciteit, weerstand van andere teams, redenen om een test uit te stellen zijn er genoeg. En toch zou je, bovenop al deze reële obstakels, het jezelf nog moeilijker kunnen maken door een extra beperking toe te voegen: slechts één test tegelijk uitvoeren, in naam van een zogenaamde statistische zuiverheid waar een lesboek rood van zou aanlopen, maar de meerderheid van de praktijkmensen juist bleek.
Dit principe van 'één test tegelijk', oorspronkelijk bedacht om de betrouwbaarheid van resultaten te beschermen, is in werkelijkheid de belangrijkste rem op je productsnelheid: weken wachttijd voor jou en je teams, terwijl je concurrenten vooruitgaan. Bij jou staat innovatie in de wachtrij.
Toch hebben de leiders in de sector dit probleem al lang opgelost, en hun aanpak is toegankelijker dan je zou denken. Denk je dat de 'usual suspects' van digitale groei – Google, Meta, Netflix, Spotify, BlaBlaCar, Leboncoin – honderden, soms duizenden tests tegelijk draaien door er telkens één voor één te doen? Natuurlijk niet. Zeker, deze giganten beschikken over buitengewone middelen, maar dat verklaart deze volumes niet: als je dit aantal tests afzet tegen de teams die ze uitvoeren, besef je dat de hefboom methodologisch is, niet budgettair. Temeer omdat sommige van hen, zoals Google of Netflix, minder paginatemplates hebben dan een e-commercesite. Elke pagina moet wel meerdere experimenten tegelijk dragen, aangezien Google Search alleen de zoekresultatenpagina kan optimaliseren. De regel van 'één tegelijk' is geen best practice meer. Het is een concurrentienadeel.
De vraag is niet langer of je je tests parallel moet laten draaien. De vraag is hoe je dit doet zonder je data of je product in gevaar te brengen.
1. Snelheid vs. Angst voor botsingen
De business-realiteit
Hoewel een geïsoleerde test statistisch wenselijk is, is hij operationeel verlammend. Elke week dat je wacht tot een test is afgerond voordat je een andere start, is een week verloren leren. Op schaal betekent dit maanden aan vertraagde beslissingen en gemiste omzet.
Neem een concreet voorbeeld. Een productteam met een backlog van 50 hypotheses en een gemiddelde cyclus van drie weken per test kan slechts 17 hypotheses per jaar valideren in sequentiële modus. Hetzelfde team kan, met de juiste waarborgen, vier tot vijf keer meer verwerken door te parallelliseren, oftewel de volledige backlog en de daaruit voortvloeiende iteraties. Het verschil is niet marginaal: op basis van een leerpercentage van 60%, waarvan een derde winnende tests, zou parallellisatie 30 extra inzichten opleveren, waaronder 10 extra winnende tests en 20 vermeden verliezen, waardoor de ROI van een experimentatieprogramma kan verdubbelen of zelfs verdrievoudigen.
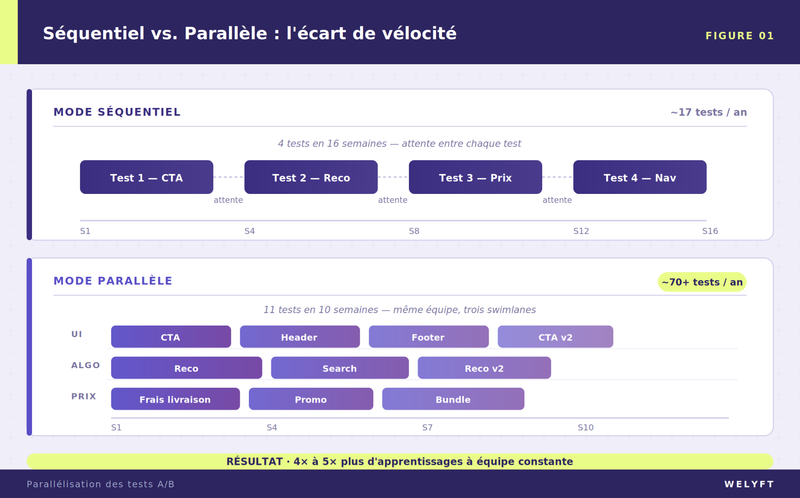
Figuur 1: modellering van de snelheidsverschillen tussen een sequentiële en geparallelliseerde roadmap
En dit verschil groeit met de tijd. Teams die sneller testen, leren sneller. Teams die sneller leren, itereren sneller. En teams die sneller itereren, veroveren een onevenredig groot deel van de waarde in hun markt. Dit is niet theoretisch: het is een samengesteld effect dat te zien is bij elke digitale leider die parallel testen tot standaardpraktijk heeft gemaakt.
Waarom isoleren? De angst voor interactie-effecten
Laten we duidelijk zijn: interactie-effecten bestaan. Als je tegelijkertijd een rode knop en een rode achtergrond test, loop je het risico je interface onleesbaar te maken voor een deel van je publiek en beide tests ongeldig te maken. Dit soort directe conflict tussen twee tests, ook wel antagonistische interacties genoemd, kan leiden tot verslechterde gebruikerservaringen en productbeslissingen die gebaseerd zijn op vertekende data.
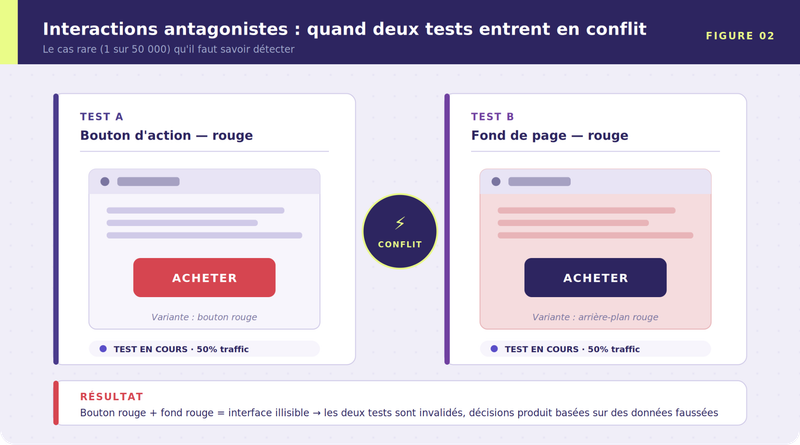
Figuur 2: illustratie van antagonistische interacties tussen twee geparallelliseerde tests op hetzelfde element
Maar de realiteit is dat de overgrote meerderheid van de interacties tussen tests niet bestaat, en nog minder significant is. Een studie van het experimentatieteam van Microsoft (Kohavi et al.), waarin honderdduizenden paren gelijktijdige tests op Bing en Microsoft-producten werden geanalyseerd, toonde aan dat interacties die sterk genoeg zijn om een productiebeslissing te vertekenen, slechts in 1 op de 50.000 gevallen voorkomen.
Eén op vijftigduizend.
Deze zeldzaamheid is eenvoudig te verklaren: het is al zeldzaam om een statistisch significant effect te ontdekken wanneer een test alleen draait (Spotify deelt leerpercentages van 64%). Het is dus nog minder frequent dat twee tests tegelijkertijd een significant resultaat opleveren, en nog zeldzamer dat dit fenomeen een productiebeslissing omkeert. Dat gezegd hebbende, kan in de zeldzame gevallen waarin sterke interacties bestaan en niet worden gemonitord, de kans om de verkeerde variant te kiezen oplopen tot ongeveer een derde van de gevallen.
Het antwoord is dus niet blind vertrouwen. Het is het opzetten van een architectuur en governance die deze parallellisatie orkestreren om interacties te detecteren wanneer ze zich voordoen en ervan te leren.
2. Hoe parallelliseer je zoals de meest gerenommeerde CRO-programma's?
De gelaagde architectuur: een roadmap met swimlanes
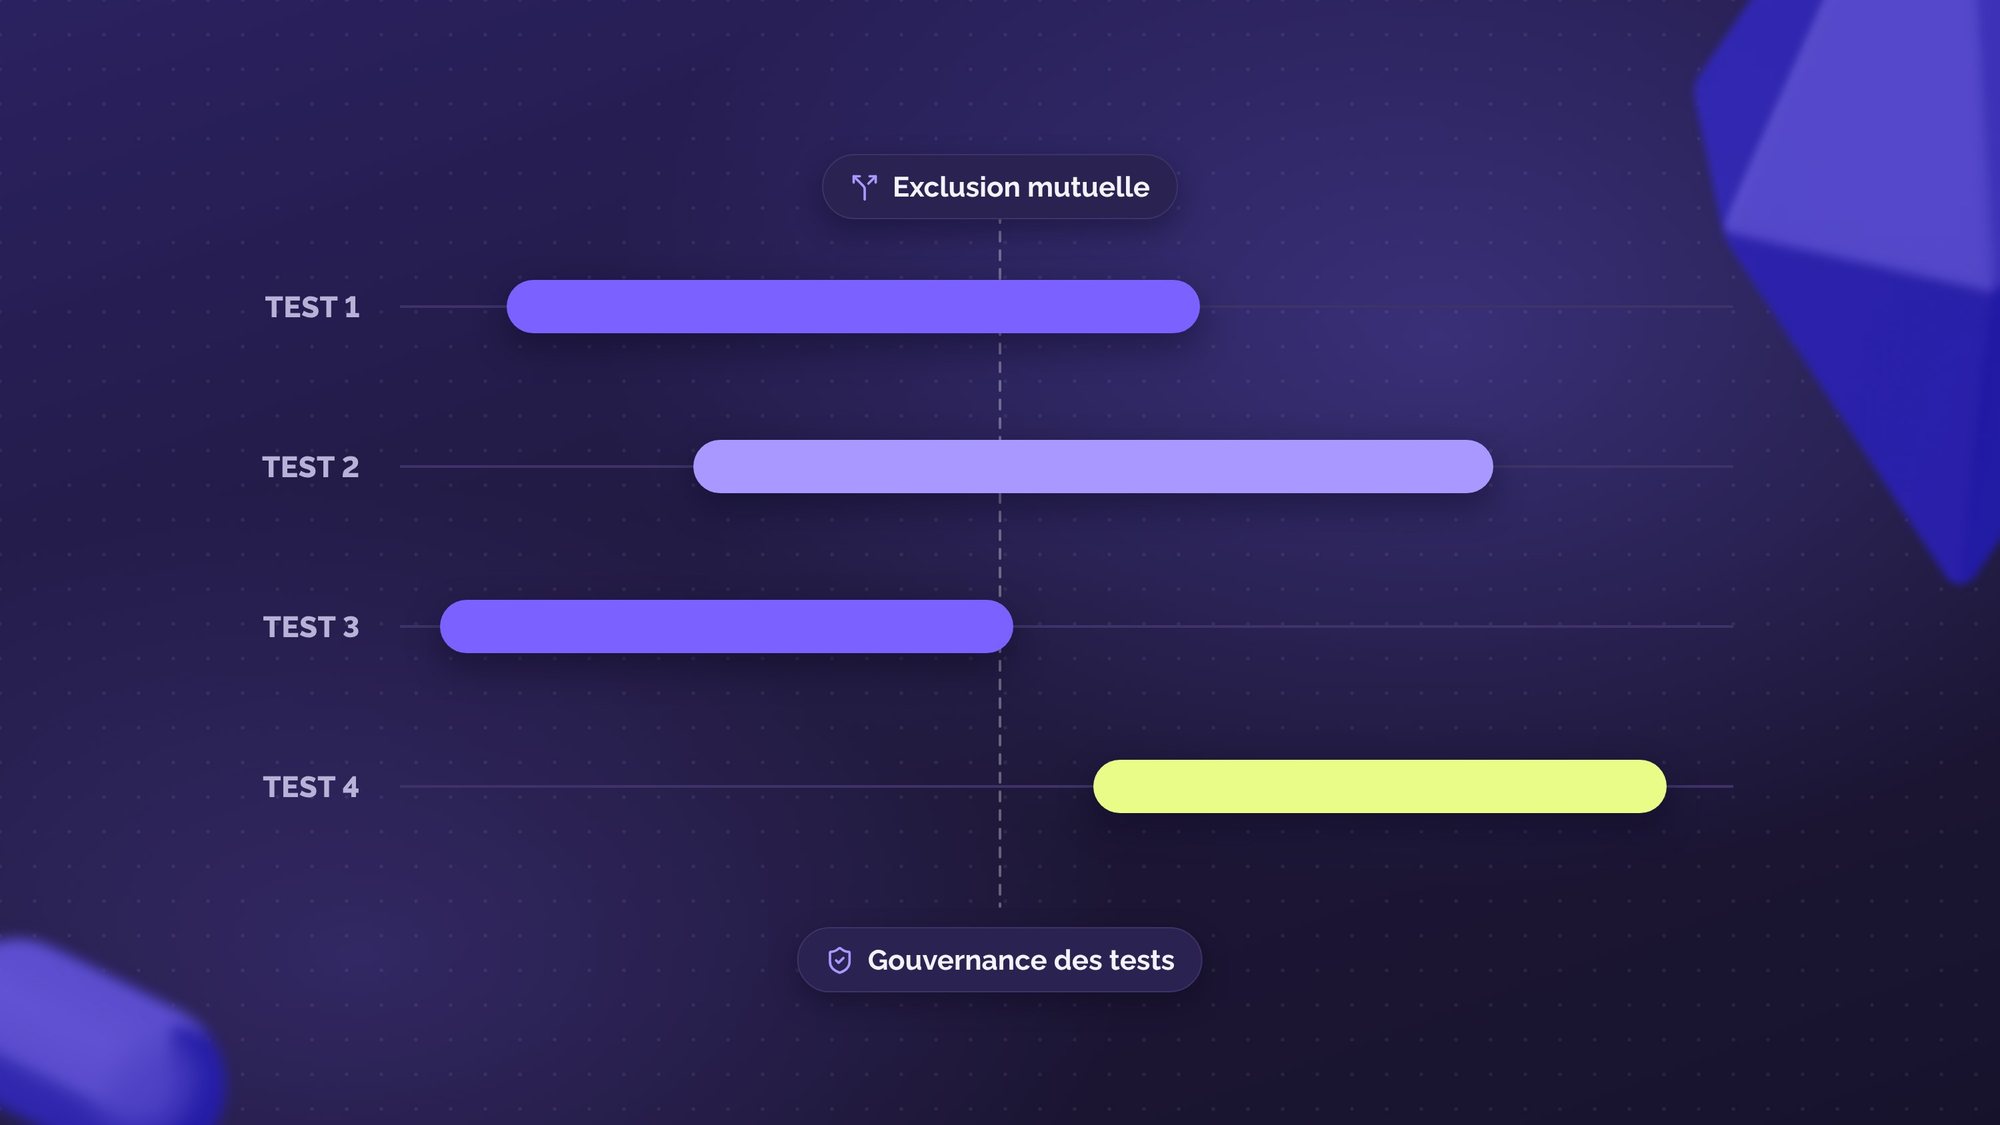
De eerste stap om veilig te parallelliseren is simpel en vereist geen geavanceerde tools: scheid je tests handmatig per scope en per element, precies zoals je een productroadmap zou organiseren met swimlanes. Elke baan vertegenwoordigt een aparte scope, wat een minimum aan interactie mogelijk maakt zonder in te leveren op snelheid. Tijdens zijn journey kan een gebruiker van de ene baan naar de andere overstappen en dus van de ene test naar de andere. En zoals we hebben gezien, is dat geen probleem: het belangrijkste is ervoor te zorgen dat je niet in een van de zeldzame gevallen terechtkomt waarin een test de interpretatie van de resultaten van de andere vertekent.

Figuur 3: Een roadmap met duidelijke lagen tussen pagina's en elementen om de parallellisatie te kaderen
Bij Welyft raden we vaak aan om te beginnen met het modelleren van een eerste laag van banen op basis van pagina- of schermtemplates, om de fasen van de journey te onderscheiden die elk hun eigen uitdagingen hebben. Als de snelheid dat vereist, kun je vervolgens een tweede laag toevoegen op basis van een vrijere indeling: per element, per type wijziging (UI, algoritmisch, pricing, enz.) of per gebruikerssegment. Zolang twee experimenten niet dezelfde scope raken, kunnen ze parallel draaien zonder risico op interferentie.
Deze logica werkt zodra je tests betrekking hebben op verschillende elementen. Als je daarentegen de interacties tussen meerdere elementen van dezelfde pagina wilt meten, kun je gebruikmaken van een multivariate test (MVT). Je hoeft dit alleen in je roadmap aan te geven door dezelfde test op meerdere banen tegelijk te vermelden.
Op een e-commerceplatform ziet dat er concreet als volgt uit: een gebruiker kan tegelijkertijd deelnemen aan een test over de wording van de leveringsstap, een test over de aanbevelingsengine en een MVT die de interacties meet tussen de CTA voor toevoegen aan winkelwagen, de positie van reviews en de lay-out van productafbeeldingen op de productpagina, zonder enige botsing, omdat elk experiment is toegewezen aan zijn eigen baan in de roadmap.
De logica van swimlanes berust op een impliciete aanname: wat je met de ene gebruiker doet, heeft geen invloed op anderen. Bij een marketplace (taxi-apps, maaltijdbezorging, serviceplatformen) houdt deze aanname geen stand, omdat het aanbod gedeeld wordt. Als een test de bestellingen aan de vraagzijde verhoogt, claimen die bestellingen bezorgers die anders de controlegroep hadden bediend: de twee groepen beïnvloeden elkaar en het waargenomen resultaat overschat het werkelijke effect. Naast interacties tussen tests is er dus een tweede soort interactie, tussen typen gebruikers, die swimlanes niet dekken. Om dit te beheersen, moet je vanaf de roadmap al specifieke technieken integreren zoals clusterrandomisatie (isoleren per geografisch gebied) of switchback testing (behandelingen afwisselen in de tijd).
Automatisering als vangnet
Deze handmatige organisatie volstaat voor de grote meerderheid van de programma's. Maar wanneer het aantal tests explodeert, wordt menselijke fout de voornaamste bedreiging, en daar komt automatisering om de hoek kijken.
Het eerste niveau van automatisering, toegankelijk voor alle teams, bestaat uit het draaien van automatische controles op actieve tests: dagelijkse jobs evalueren alle paren lopende tests en signaleren significante interacties. Het zeldzame geval van 1 op de 50.000 wordt gedetecteerd; al het andere draait vrij. De houding is duidelijk: standaard parallelliseren, continu monitoren, alleen isoleren wanneer de data daarom vragen.
Voor programma's met een zeer groot volume is een tweede niveau mogelijk: de architectuur van de roadmap zelf formaliseren met technische mechanismen (aparte hash-salts per laag, onafhankelijke toewijzing van gebruikers), wat isolatie door ontwerp garandeert. Maar voor de grote meerderheid van de teams is dit investeringsniveau niet gerechtvaardigd: een goed georganiseerde roadmap met swimlanes volstaat om het grootste deel van de snelheidswinst te behalen.
3. Waarom techniek niet volstaat?
Alles wat we zojuist hebben gezien, swimlanes, MVT, automatisering, is technisch haalbaar. En toch slagen heel weinig organisaties hier echt in. Waarom? Omdat het echte knelpunt nooit de tool is. Het is alles wat eromheen moet bestaan.
Het echte probleem is organisatorisch
Wanneer meerdere teams tegelijk tests kunnen lanceren, moet iemand de spelregels bezitten. Wie mag wat testen, op welke laag? Wat vormt een geldige KPI? Wanneer is een test voldoende matuur om te worden afgerond? Wie beslist wanneer twee tests hetzelfde segment targeten? Automatisering past regels toe, maar schrijft ze niet. Zonder duidelijke governance creëert parallellisatie verwarring, geen waarde.
Vertrouwen als motor voor verandering
En zelfs met duidelijke regels blijft er een lastiger obstakel: ervoor zorgen dat deze regels worden geaccepteerd. Senior decisionmakers die hun instinct hebben opgebouwd op basis van geïsoleerde resultaten, zullen conclusies uit geparallelliseerde tests vaak verwerpen, vooral ongunstige conclusies, uit reflex in plaats van op basis van analyse. 'Deze resultaten zijn niet betrouwbaar, er liepen andere tests tegelijk' wordt een handig argument om lastige data te negeren.
Dat is precies wat governance moet opleveren: institutioneel vertrouwen opbouwen in het methodologische kader is net zo belangrijk als het kader zelf opbouwen. Dat vraagt om uitleg, reproduceerbare resultaten en volledige transparantie over de methodologie; niet om nóg een slide deck voor het directiecomité.
Het belang van specifieke expertise
Governance bezitten en dit vertrouwen opbouwen, is een vak apart. Organisaties die hun parallelle experimentatieprogramma's opschalen, hebben allemaal één gemeenschappelijk kenmerk: een toegewijde functie die de methodologie, de governanceregels en de competentieontwikkeling van de teams beheert. Bij Google of Netflix is dat een heel leger interne specialisten, een luxe die voor de meeste Franse en Europese bedrijven noch realistisch, noch economisch rationeel is.
Welyft structureert en versnelt de programma's van zijn klanten om maximale inzichten te leveren, zonder ooit de betrouwbaarheid van de resultaten in gevaar te brengen, van testarchitectuur tot programmagovernance, tot en met de training van besluitvormers.
Ga aan de slag
Je A/B-tests parallelliseren is geen roekeloze gok die voorbehouden is aan techgiganten met miljoenen dagelijkse gebruikers. Het is de operationele standaard voor elk digitaal team dat serieus werk maakt van groei.
De echte uitdaging is niet statistisch; dat bewijzen het onderzoek van Microsoft en de praktijken van de grootste experimenteerders. Het is organisatorisch. Teams die zichzelf beperken uit angst voor interacties falen niet omdat die angsten bewaarheid worden. Ze falen omdat niemand de governance bezat en niemand het vertrouwen had opgebouwd dat nodig is om te handelen op resultaten die niet 'zuiver' aanvoelen.
Precies dit type statistische, technische en organisatorische uitdaging begeleidt Welyft dagelijks bij Franse en Europese digitale teams. Van experimentatiearchitectuur tot programmagovernance, inclusief de training van beslissers, onze aanpak is ontworpen voor de realiteit van jouw markt, AVG incluis.
Wil je je verder verdiepen voordat je begint? We hebben een volledig overzicht samengesteld van statistische kaders, architecturen en praktijken van de beste experimentatieteams ter wereld, een concrete gids om je eigen aanpak te structureren.