Growth Manager、CRO担当者、あるいはProduct Ownerであれば、この瞬間をご存知でしょう。アイデアはあってもロードマップがなく、40件のテストアイデアを抱えたバックログ、溢れかえるJiraのボード、そしてすべてを止めてしまうたった一つの問い「どこから始めるべきか?」です。
時間と利用可能な開発者が不足しているため、あるテストを実施することは、別のテストのチャンスを奪うことを意味します。問題は、共通の枠組みがない場合、この決定がしばしば直感、その時の緊急性、あるいは会議で最も説得力のある人の意見に基づいて下されてしまうことです。結果として、貴重なリソースが低いポテンシャルの最適化に投じられる一方で、本当の成長レバーはバックログの下位で待たされ続けることになります。
Welyftでは、CROエージェントとして、優先順位付けがクライアントとともに最初に取り組む課題です。そして数年前から、私たちの実験ロードマップは明確なフレームワーク、すなわちRICES(Reach, Impact, Confidence, Effort, Strategy)に基づいています。この記事では、私たちが実際にどのようにこれを活用しているか、自分たちのアイデアをどう採点するか、そしてなぜこれが単なる公式ではなく真のCROガバナンスツールなのかを説明します。
なぜすべての最適化が同等の価値を持たないのか?
CROロードマップは、アイデア不足によって制限されることは決してありません。制限されるのは時間、開発リソース、そしてチームの注意力です。各テストにはコストがかかります。それが設計、開発、QAの時間であれ、あるいは単にテスト期間中に割かれるトラフィックであれです。
しかし、優先順位付けの手法がなければ、私たちが支援している組織では常に2つのバイアスが繰り返し現れます。
- HiPPOバイアス(Highest Paid Person's Opinion):決定が、アイデアの実際のポテンシャルではなく、その場で最も地位の高い人の意見に基づいて下される。
- 安易さのバイアス:チームは、最も収益性の高いテストではなく、開発が最も簡単なテストに取り組む傾向がある。これは快適さや「スピード感を見せたい」という意図によるもの。
フレームワークはまさにこの2つの落とし穴に対する防波堤として機能します。各アイデアに客観的かつ共有されたスコアを付与することで、意見の対立を共通基準に基づく議論へと変えます。もはや「このテストが優先だと思う」ではなく、「このテストは6.4点、あちらは4.4点、理由はこうだ」という話になります。
この直感からスコアリングへの転換こそが、オーダーメイドのCROプログラムを構築し、優先順位付けを単なるバックログ整理作業ではなく、組織的な価値創出の真の手段にすることを可能にします。
この手法の5つの基準
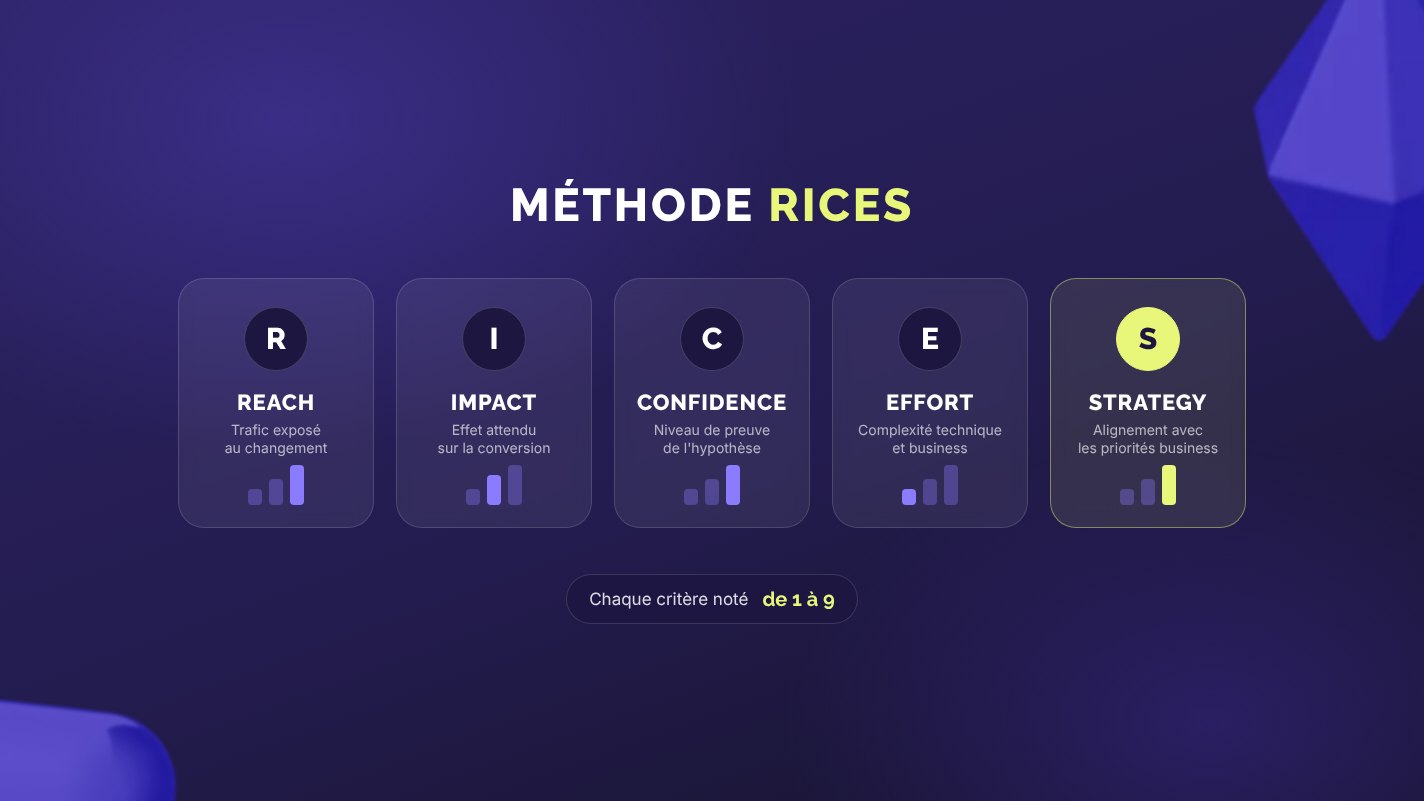
RICESは、グロースチームによって広められたRICEフレームワークを基にしており、Welyftではそこに5つ目の柱であるStrategyを加えています。なぜでしょうか?それは、あるテストが短期的には収益性が高くても、必ずしもその時点のビジネス優先事項に資するとは限らないからです。この5つ目の基準は、ロードマップを即時のパフォーマンスだけでなく、企業のビジョンと整合させる役割を果たします。
ここでは、5つの基準それぞれをどのように分解しているかをご紹介します。
Reach:変更の可視性
Reachは、一定期間(通常は1ヶ月)にテスト対象の変更にさらされるユーザーの量を測定します。トラフィックの100%が閲覧する商品ページでのテストは、ログイン済みの一部のユーザーしか訪れないアカウントページでのテストよりも、はるかに高いReachを持ちます。
- 自問すべき問い:具体的に何人のユーザーがこのバリエーションを目にするか?
- Welyftで使用しているスケール:1(限定的なオーディエンス)から9(トラフィックのほぼ全体)まで。
Impact:ユーザー体験への期待される効果
Impact(インパクト)は、対象となるユーザーの行動、ひいてはコンバージョンに期待される効果の大きさを評価します。ユーザーリサーチで特定された大きな摩擦を解消する変更はImpactが高くなります。多くの人に影響する変更であっても、見た目の調整程度であればImpactは低くなります。
- 自問すべき問い:この変更がうまくいった場合、対象KPIにどれほどの効果が見込めるか?
- Welyftで使用するスケール:1(わずかな効果)から9(コンバージョンの大きなレバー)まで。
Confidence:仮説を裏付ける証拠のレベル
Confidenceは、仮説を支えるデータの確かさに応じて、前述の2つの基準を調整する役割を持ちます。複数のインサイト(定量データ、ユーザーの声、セッションリプレイ)を組み合わせた根拠に基づくテストは、高いConfidenceに値します。単なる直感、たとえそれが優れたものであっても、それに基づくテストは評価を下げるべきです。
- 自問すべき問い:この仮説は何に基づいているか?確かなデータか、それとも単なる勘か?
- Welyftで使用するスケール:1(直感や業界ベンチマーク)から9(複数の裏付けが一致する証拠)まで。
Effort:技術的複雑さとビジネス的複雑さの二重性
Effortもスコアに含まれます。労力が大きいほど評点は低くなり、最終結果への影響も大きくなります。この手法が真価を発揮するのはここで、Effortは開発負荷だけにとどまりません。これは2つの側面を組み合わせたものです。
- 技術的複雑さ:修正が必要なコンポーネントの数、他チームとの依存関係、インフラ上の制約。
- ビジネス的複雑さ:法務承認、他チャネルへの影響、実施前に複数の関係者間で合意を取る必要性。
- 自問すべき問い:このテストを実施するために、実際にどれほどの時間とリソース(開発、デザイン、承認)が必要か?
- Welyftで使用するスケール:1(数週間にわたる複数分野にまたがる取り組み)から9(数時間の開発で済むクイックウィン)まで。
具体例:すべての商品ページに表示される「共有可能なウィッシュリスト」という機能のアイデアは、ほぼすべてのトラフィックに見られるため、Reachは9と高くなる可能性があります。しかし、その実装に新しいデータベーススキーマ、通知システム、複数コンポーネントの刷新が必要な場合、Effortは9点中1点となります。この技術的複雑さが、非常に高い可視性のポテンシャルにもかかわらず、最終スコアを直接押し下げることになります。
Strategy:企業の優先事項との整合性
これは、私たちが従来のRICEに追加した柱です。Strategyは、そのテストが現時点の優先的な戦略軸、すなわち新しいオファーのローンチ、経営陣が定めた四半期目標、国際展開における優先市場などに資するかどうかを測るものです。紙の上では完全に収益性の高いテストであっても、ビジネス優先事項と切り離されている場合は、バックログに残しつつも、ロードマップの上位には上げないようにすべきです。
- 自問すべき問い:このテストは、組織が今年掲げる戦略目標に資するものか?
- Welyftで使用するスケール:1(戦略軸ではない)から9(重要な戦略的優先事項と整合している)まで。
スコアの算出方法
5つの基準を採点したら、計算はシンプルです。5つの点数の平均を取ります。
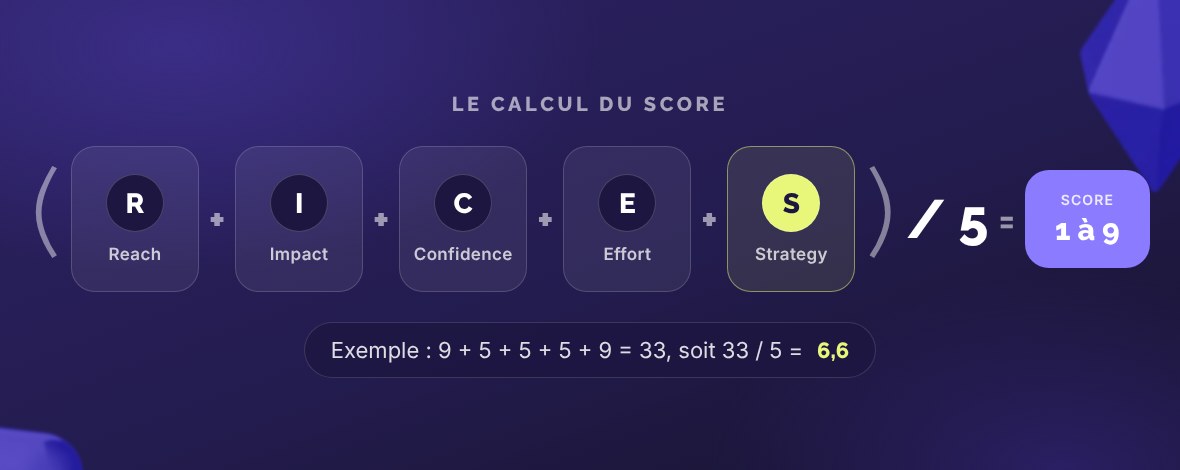
ルールは明快です。スコアが高いほど、テストの優先度も高くなります。すべての基準の平均を取ることで、単一の基準だけで他の側面における弱さを補うことができないことが保証されます。優れたReachも低いConfidenceを補うことはできません。最小限のEffortも取るに足らないImpactを取り戻すことはできません。
具体例を挙げましょう。あるテストのアイデアが次のような点数を得たとします:Reach = 9、Impact = 5、Confidence = 5、Effort = 5、Strategy = 9。
- 9(Reach) + 5(Impact) + 5(Confidence) + 5(Effort) + 9(Strategy) = 33
- 33 / 5 = 6.6
したがって、このテストのスコアは6.6となります。単独ではこの数字自体に意味はありません。バックログにある他のアイデアのスコアと比較することで初めて意味を持ち、ロードマップの順序を客観的に決定できるようになります。
Welyftにおけるスコアリングの例
ここでは、このフォーミュラをeコマース向けのテストバックログに適用する方法をご紹介します。この表の面白さは、まさに驚きを明らかにしてくれる点にあります。会議では「当たり前」に思えたアイデアが順位の下位に沈む一方で、目立たない細かな最適化が上位に浮上することもあるのです。
| テストのアイデア | Reach | Impact | Confidence | Effort | Strategy | Score |
|---|---|---|---|---|---|---|
| カート用CTAの下に安心感を与えるバッジ(「送料無料」)を追加する | 9 | 4 | 7 | 9 | 3 | 6.4 |
| メインCTAボタンの色を変更する | 7 | 3 | 7 | 9 | 2 | 5.6 |
| 商品詳細ページに会話型AIチャットボットを導入する | 8 | 7 | 4 | 1 | 7 | 5.4 |
| 商品詳細ページに共有可能なウィッシュリスト機能を追加する | 8 | 4 | 5 | 1 | 4 | 4.4 |
この順位付けは、このメソッドがロードマップの順序を実際にどう変えるかをよく示しています。安心感を与えるバッジは、見た目には小さな変更ですが、Effortがほぼゼロで、Confidenceが高い(安心材料によるレバーはCROの分野で広く実証されています)ため、トップに立ちます。逆に、しばしば戦略的な「大勝負」とみなされるAIチャットボットは、より下位に位置します。ポテンシャルは存在するものの、仮説を裏付ける確かなデータがない限りConfidenceは低いままであり、Effortも計算に重くのしかかるのです。
これは、こうした野心的なテストを諦めるべきだという意味ではありません。まずはユーザーテストや低コストのプロトタイプなどを通じてリスクを軽減し、その上で本格的なA/B testとして開発すべきです。そうすればスコアは自然に変化します。新たなインサイトによってConfidenceが強化されれば、テストは順位表の中で自動的に上昇していきます。
成熟したCRO戦略を支えるメソッド
計算そのものを超えて、RICESの本当の価値は組織的なものにあります。Growth Manager、開発者、デザイナー、意思決定者の間に共通言語を確立することで、以下が可能になります。
- 関係者に対してロードマップを正当化する。ステークホルダーが「なぜこのテストがあのテストより先なのか?」と尋ねたとき、答えはもはや主観的な意見ではなく、透明性があり再現可能なスコアリングに基づくものとなります。
- 暗黙の裁量を可視化する。Effortという基準は、開発チームを動かす前に、あるアイデアの実際のコストを即座に思い出させてくれます。
- エビデンスの文化を築く。 Confidenceを重視することで、このメソッドはチームに対し、印象ではなくデータに基づいて仮説を記録することを促し、実験プログラム全体の質を高めます。
- 戦略的な方向性を維持する。Strategyという基準のおかげで、ロードマップが単なるスコア競争になることはなく、企業の真の優先事項と常に結びついたままとなります。
Welyftでは、計画サイクルごと、通常は4〜6週間ごとにスコアを再計算しています。スコアは決して固定されたものではありません。新たなインサイトが得られるたびに(CRO監査やContinuous Discoveryのアプローチを通じて)、Confidenceが変化し、それに伴って優先順位も変わります。この継続的な反復こそが、単発のスコアリング演習ではなく、真のロードマップの推進力となるのです。
FAQ:RICES手法についてのよくある質問
RICE手法とRICES手法の違いは何ですか?
従来のRICE(Reach、Impact、Confidence、Effort)は、製品機能の優先順位付けのためにグロースチームによって広められました。Welyftでは、CROのロードマップが各テストの純粋な収益性だけでなく、その時々のビジネス上の優先事項と常に一致するよう、5つ目の基準であるStrategyを追加しています。
各基準はどのような尺度で評価すべきか?
普遍的なスケールは存在しません。重要なのはテストごとに一貫性を保つことです。Welyftでは各基準を1から9で評価し、その平均を算出しています。
スコアは専門家の判断に取って代わるのか?
いいえ、それを構造化するものです。このメソッドはCROの専門知識を不要にするものではありません。特にImpactとConfidenceに適切な評価を与えられるのは、まさにチームの経験があってこそです。このフレームワークは議論を客観化するためのものであり、自動計算に置き換えるためのものではありません。
スコアはどのくらいの頻度で再計算すべきか?
ロードマップの計画サイクルごと、つまり4〜6週間ごとにスコアリングを見直すことをお勧めします。以前のテスト、ユーザーインタビュー、データ分析のいずれから得られた新たなインサイトであっても、アイデアのConfidenceを変化させ、ひいてはその優先順位を変える可能性があります。
スコアリングを管理するにはどのようなツールを使うべきか?
始めるには単純な表計算ソフトで十分です。アイデアごとに1行、基準ごとに1列、そして最終スコアを算出する自動化された数式を用意します。より成熟したチームは、このスコアリングをロードマップ管理ツール(Notion、Airtable、Jira)に直接組み込み、CROプログラム全体と連携させています。
RICESメソッドは、あなたに代わって決定を下す魔法の公式ではありません。それは、各アイデアが開発リソースを動員する前に、5つの次元でその価値を証明することを強制する、集団的な規律のためのツールです。定期的に活用することで、CROロードマップは単なる願望リストから、ビジネスに実際にもたらす価値に基づいて優先順位付けされた、真の投資ポートフォリオへと変貌します。