سواء كنت Growth Manager أو CRO أو Product Owner، فأنت تعرف هذه اللحظة جيدًا: أفكار كثيرة ولكن بلا خارطة طريق، قائمة انتظار من 40 فكرة اختبار، لوحة Jira مليئة، وسؤال واحد يوقف كل شيء: «من أين نبدأ؟»
بسبب ضيق الوقت وقلة المطورين المتاحين، كل اختبار يُطلق يحرم اختبارًا آخر من فرصته. المشكلة أنه بدون إطار مشترك، غالبًا ما يُبنى هذا القرار على الحدس، أو إلحاح اللحظة، أو رأي الشخص الأكثر إقناعًا في الاجتماع. والنتيجة: موارد ثمينة تُستثمر في تحسينات ذات إمكانات ضعيفة، بينما تنتظر الروافع الحقيقية للنمو في أسفل القائمة.
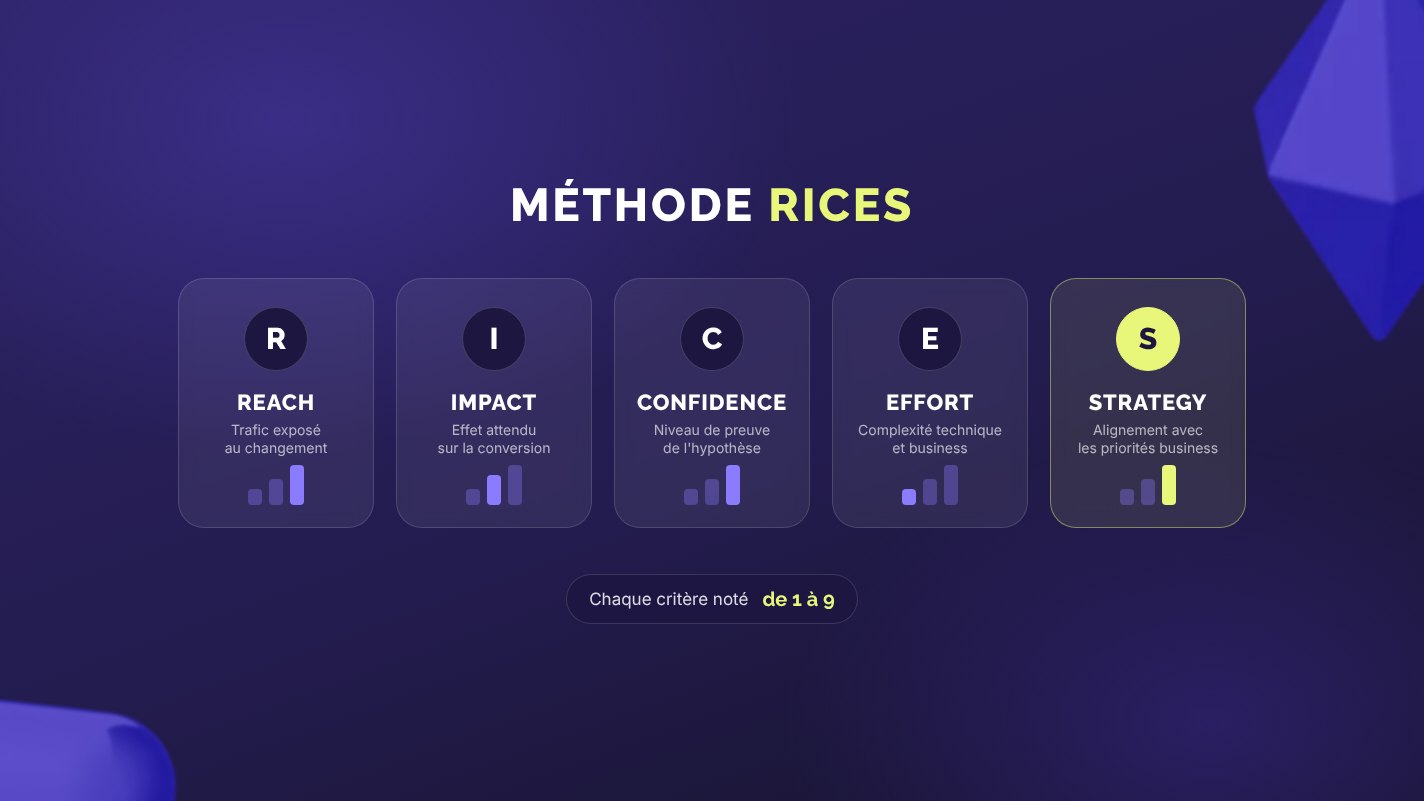
في Welyft، بصفتنا وكالة CRO، يُعد تحديد الأولويات أول ورشة نفتحها مع عملائنا. ومنذ عدة سنوات، تعتمد خارطة طريق التجارب لدينا على إطار عمل دقيق: RICES (Reach, Impact, Confidence, Effort, Strategy). في هذا المقال، نشرح لكم كيف نستخدمه عمليًا، وكيف تقيّمون أفكاركم الخاصة، ولماذا لا يُعد مجرد معادلة بل أداة حوكمة CRO حقيقية.
لماذا لا تتساوى جميع التحسينات في القيمة؟
خارطة طريق CRO لا تكون أبدًا محدودة بنقص الأفكار. بل هي محدودة بالوقت وقدرة التطوير واهتمام الفرق. كل اختبار يكلّف موارد، سواء كان ذلك وقت تصميم أو تطوير أو اختبار جودة (QA) أو ببساطة حركة مرور تُستهلك طوال مدة الاختبار.
وبدون منهجية لتحديد الأولويات، يتكرر انحرافان بشكل منهجي في المؤسسات التي نرافقها:
- انحياز HiPPO (Highest Paid Person's Opinion): حيث تُتخذ القرارات وفقًا لرأي الشخص الأعلى منصبًا في الغرفة، وليس وفقًا للإمكانات الفعلية للفكرة.
- انحياز السهولة: حيث تتجه الفرق نحو الاختبارات الأسهل تطويرًا بدلًا من الأكثر ربحية، إما راحةً أو رغبةً في «إظهار سرعة الإنجاز».
يعمل هذا الإطار تحديدًا كضمانة أمام هذين الانحرافين. فمن خلال إسناد درجة موضوعية ومشتركة لكل فكرة، يحوّل النقاش من جدل في الآراء إلى نقاش يستند إلى معايير مشتركة. لم يعد الأمر «أعتقد أن هذا الاختبار له الأولوية» بل «هذا الاختبار يحصل على 6.4، وذاك على 4.4، وإليكم السبب».
هذا التحوّل، من الحدس إلى التقييم بالدرجات، هو ما يسمح ببناء برنامج CRO مخصص وجعل تحديد الأولويات رافدًا حقيقيًا للقيمة التنظيمية، وليس مجرد عملية فرز لقائمة الانتظار.
المعايير الخمسة للمنهجية
يستلهم RICES من إطار RICE الذي عمّمته فرق النمو، وقد أضفنا إليه في Welyft ركيزة خامسة: Strategy. ولماذا؟ لأن الاختبار قد يكون مربحًا على المدى القصير دون أن يخدم بالضرورة أولويات العمل في تلك اللحظة. هذا المعيار الخامس يحافظ على توافق خارطة الطريق مع رؤية الشركة، وليس فقط مع الأداء الفوري.
إليكم كيف نُفصّل كل معيار من المعايير الخمسة.
Reach: مدى ظهور التغيير
يقيس Reach حجم المستخدمين المعرّضين للتعديل المُختبر خلال فترة معينة (عادةً شهر واحد). الاختبار على صفحة منتج، تشاهدها 100% من حركة المرور، سيكون له Reach أعلى بكثير من اختبار على صفحة حساب العميل، التي يزورها عدد قليل من المستخدمين المسجلين.
- السؤال الذي يجب طرحه: كم عدد المستخدمين الذين سيشاهدون فعليًا هذا التغيير؟
- المقياس المستخدم في Welyft: من 1 (جمهور محدود جدًا) إلى 9 (شبه كامل حركة المرور).
Impact: الأثر المتوقع على تجربة المستخدم
يقيّم معيار Impact حجم الأثر المتوقع على سلوك المستخدم المعرَّض للتغيير، وبالتالي على التحويل. التغيير الذي يزيل احتكاكًا رئيسيًا تم تحديده في أبحاث المستخدمين سيكون له Impact مرتفع. أما التعديل الشكلي فسيكون Impact أقل، حتى لو كان يطال عددًا كبيرًا من المستخدمين.
- السؤال الذي يجب طرحه: إذا نجح هذا التغيير، ما حجم المكسب على مؤشر الأداء (KPI) المستهدف؟
- المقياس المعتمد لدى Welyft: من 1 (أثر هامشي) إلى 9 (رافعة تحويل رئيسية).
Confidence: مستوى الدليل وراء الفرضية
يعمل معيار Confidence على ترجيح المعيارين السابقين وفق متانة البيانات الداعمة للفرضية. فالاختبار المبني على تقاطع معطيات متعددة (بيانات كمية، آراء المستخدمين، إعادة تشغيل الجلسات) يستحق Confidence مرتفعة. أما الاختبار المبني على مجرد حدس، مهما كان ذكيًا، فيجب تقييمه بدرجة أقل.
- السؤال الذي يجب طرحه: على ماذا تستند هذه الفرضية؟ على بيانات متينة، أم على مجرد شعور؟
- المقياس المعتمد لدى Welyft: من 1 (حدس أو مقارنة قطاعية) إلى 9 (أدلة متعددة ومتقاربة).
Effort: الازدواجية بين التعقيد التقني وتعقيد الأعمال
يدخل معيار Effort أيضًا في حساب الدرجة: فكلما زاد الجهد المطلوب، انخفضت درجته، وزاد تأثيره السلبي على النتيجة النهائية. وهنا يتجلى المعنى الحقيقي للمنهجية، إذ لا يقتصر Effort على عبء التطوير فحسب، بل يجمع بين بُعدين:
- التعقيد التقني: عدد المكوّنات الواجب تعديلها، الترابط مع فرق أخرى، قيود البنية التحتية.
- التعقيد التجاري: التصديق القانوني، الأثر على قنوات أخرى، ضرورة التنسيق بين عدة أطراف معنية قبل الإطلاق.
- السؤال الذي يجب طرحه: كم من الوقت والموارد (تطوير، تصميم، تصديق) مطلوبة فعليًا لإنجاز هذا الاختبار؟
- المقياس المعتمد لدى Welyft: من 1 (مشروع متعدد التخصصات يستغرق عدة أسابيع) إلى 9 (quickwin، بضع ساعات من التطوير).
مثال عملي: فكرة ميزة «قائمة أمنيات قابلة للمشاركة» موجودة في جميع صفحات المنتجات قد تحصل على Reach مرتفع يبلغ 9، لأنها مرئية لمعظم الزيارات. لكن إذا تطلّب تنفيذها مخططًا جديدًا لقاعدة البيانات، ونظام إشعارات، وإعادة تصميم عدة مكوّنات، فإن Effort سيكون 1 من 9. هذا التعقيد التقني يقلّص مباشرة من الدرجة النهائية، رغم إمكانية الظهور العالية جدًا.
Strategy: التوافق مع أولويات الشركة
هذه هي الركيزة التي أضفناها إلى إطار RICE الكلاسيكي. يقيس معيار Strategy ما إذا كان الاختبار يخدم محورًا استراتيجيًا ذا أولوية في تلك المرحلة: إطلاق عرض جديد، هدف ربع سنوي حددته الإدارة، سوق دولي ذو أولوية، إلخ. فالاختبار المربح تمامًا نظريًا، لكنه منفصل عن أولويات العمل، يجب أن يبقى ظاهرًا في قائمة الأفكار دون أن يتصدّر خارطة الطريق.
- السؤال الذي يجب طرحه: هل يخدم هذا الاختبار هدفًا استراتيجيًا حددته المؤسسة هذا العام؟
- المقياس المعتمد لدى Welyft: من 1 (ليس محورًا استراتيجيًا) إلى 9 (متوافق مع أولوية استراتيجية حاسمة).
كيف تُحسب الدرجة؟
بمجرد تقييم المعايير الخمسة، يصبح الحساب بسيطًا: نحسب متوسط الدرجات الخمس.
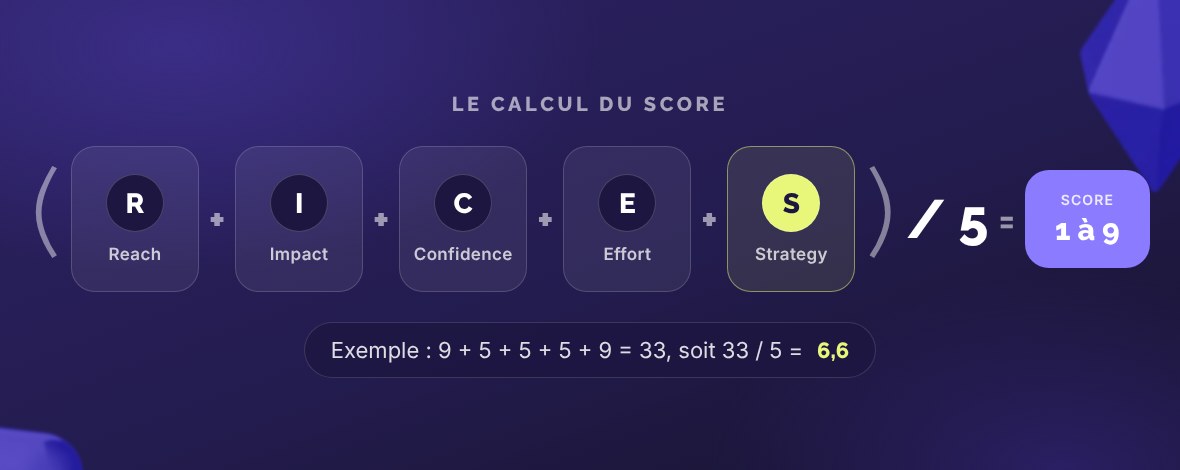
القاعدة واضحة: كلما ارتفعت الدرجة، زادت أولوية الاختبار. يضمن حساب متوسط جميع المعايير أن أي معيار بمفرده لا يمكنه إنقاذ فكرة ضعيفة في الأبعاد الأخرى. فـ Reach استثنائي لا يعوّض عن Confidence منخفضة. وEffort منخفض لا يعوّض عن Impact ضئيل.
لنأخذ مثالًا كاملًا. فكرة اختبار تحصل على الدرجات التالية: Reach = 9، Impact = 5، Confidence = 5، Effort = 5، Strategy = 9.
- 9 (Reach) + 5 (Impact) + 5 (Confidence) + 5 (Effort) + 9 (Strategy) = 33
- 33 / 5 = 6.6
يحصل هذا الاختبار إذن على درجة 6.6. هذا الرقم بمفرده لا يعني شيئًا. ومقارنته بدرجات الأفكار الأخرى في قائمة الأفكار هي ما يمنحه معناه الحقيقي ويسمح بالفصل الموضوعي في ترتيب خارطة الطريق.
مثال على التقييم في Welyft
إليك كيف نطبّق هذه المعادلة على قائمة اختبارات نموذجية للتجارة الإلكترونية. الفائدة من الجدول هي بالضبط كشف المفاجآت: أفكار «بديهية» أثناء الاجتماع قد تنتهي في أسفل الترتيب، بينما تصعد تحسينات دقيقة ومتواضعة إلى القمة.
| فكرة الاختبار | Reach | Impact | Confidence | Effort | Strategy | Score |
|---|---|---|---|---|---|---|
| إضافة شارة طمأنة («الشحن مجاني») تحت زر الـCTA الخاص بالسلة | 9 | 4 | 7 | 9 | 3 | 6,4 |
| تغيير لون زر الـCTA الرئيسي | 7 | 3 | 7 | 9 | 2 | 5,6 |
| تطوير روبوت محادثة بالذكاء الاصطناعي على صفحات المنتج | 8 | 7 | 4 | 1 | 7 | 5,4 |
| إضافة ميزة قائمة رغبات قابلة للمشاركة على صفحات المنتج | 8 | 4 | 5 | 1 | 4 | 4,4 |
يوضح هذا الترتيب جيدًا لماذا تغيّر هذه المنهجية فعليًا ترتيب خارطة الطريق. فشارة الطمأنة، وهي تعديل بسيط في ظاهره، تحتل المرتبة الأولى بفضل جهد شبه معدوم ومستوى Confidence مرتفع (فائدة عنصر الطمأنة موثّقة بشكل واسع في CRO). على العكس، فإن روبوت المحادثة بالذكاء الاصطناعي، الذي يُنظر إليه غالبًا على أنه «رهان كبير» استراتيجي، يحتل مرتبة أدنى: الإمكانية موجودة، لكن Confidence تبقى منخفضة ما دامت لا توجد بيانات قوية تثبت الفرضية، كما أن الـEffort يثقل كثيرًا في الحساب.
هذا لا يعني أن هذه الاختبارات الطموحة يجب التخلي عنها. بل يجب أولًا تقليل مخاطرها، مثلًا عبر اختبار مستخدم أو نموذج أولي منخفض التكلفة، قبل تطويرها إلى A/B test كامل. عندها تتطور النتيجة بشكل طبيعي: فبمجرد تعزيز Confidence بمعطيات جديدة، يرتفع الاختبار تلقائيًا في الترتيب.
منهجية في خدمة استراتيجية CRO ناضجة
بعيدًا عن الحساب، القيمة الحقيقية لمنهجية RICES تنظيمية بالدرجة الأولى. فمن خلال فرض لغة مشتركة بين Growth Managers والمطورين والمصممين وصناع القرار، تتيح هذه المنهجية:
- الدفاع عن roadmap أمام أصحاب المصلحة. عندما يسأل أحد stakeholders «لماذا هذا الاختبار قبل ذاك؟»، لا يعتمد الرد على رأي شخصي بل على scoring شفاف وقابل لإعادة التطبيق.
- إظهار المفاضلات الضمنية. معيار Effort يذكّر فورًا بالتكلفة الفعلية لفكرة ما، حتى قبل إشراك فرق التطوير.
- بناء ثقافة قائمة على الإثبات. من خلال تعزيز قيمة Confidence، تدفع هذه المنهجية الفرق إلى توثيق فرضياتها بالبيانات بدلًا من الانطباعات، ما يرفع من جودة برنامج التجريب بأكمله.
- الحفاظ على التوجه الاستراتيجي. بفضل معيار Strategy، لا تتحول الـ roadmap أبدًا إلى مجرد سباق على الـ score: فهي تبقى مرتبطة بالأولويات الفعلية للشركة.
في Welyft، نعيد احتساب النتائج في كل دورة تخطيط، عادةً كل 4 إلى 6 أسابيع. فالنتيجة ليست ثابتة أبدًا: فمع وصول رؤى جديدة (عبر audit CRO أو عملية Continuous Discovery)، تتطور Confidence، وبالتالي تتغير الأولوية أيضًا. هذا التكرار المستمر هو ما يجعل منها محرّكًا حقيقيًا لخارطة الطريق، وليس مجرد تمرين تقييم لمرة واحدة.
الأسئلة الشائعة: أسئلتكم حول طريقة RICES
ما الفرق بين طريقة RICE وطريقة RICES؟
تم تعميم منهجية RICE الكلاسيكية (Reach وImpact وConfidence وEffort) من قبل فرق النمو لترتيب أولويات ميزات المنتج. في Welyft، أضفنا معيارًا خامسًا، وهو Strategy، لضمان أن تظل خارطة طريق CRO متوافقة دائمًا مع أولويات العمل الحالية، وليس فقط مع الربحية الخام لكل اختبار.
على أي مقياس يتم تقييم كل معيار؟
لا يوجد مقياس موحّد عالميًا: المهم هو الحفاظ على الاتساق من اختبار إلى آخر. لدى Welyft، نقيّم المعايير من 1 إلى 9 ونحسب المتوسط.
هل تحل النتيجة محل حكم الخبير؟
لا، بل تنظّمه. فهذه المنهجية لا تغني عن خبرة CRO: فخبرة الفريق هي بالضبط ما يسمح بإعطاء تقييمات دقيقة، لا سيما بخصوص Impact وConfidence. يُستخدم الإطار لإضفاء الموضوعية على النقاش، لا لاستبداله بحساب آلي.
ما هي الوتيرة المناسبة لإعادة احتساب النتائج؟
نوصي بمراجعة التقييم في كل دورة تخطيط لخارطة الطريق، أي كل 4 إلى 6 أسابيع. فكل رؤية جديدة، سواء جاءت من اختبار سابق أو مقابلة مع مستخدم أو تحليل بيانات، يمكن أن تغيّر مستوى Confidence لفكرة ما وبالتالي أولويتها.
ما الأدوات التي يمكن استخدامها لإدارة التقييم؟
يكفي جدول بيانات بسيط للبدء: سطر لكل فكرة، وعمود لكل معيار، ومعادلة آلية للنقاط النهائية. أما الفرق الأكثر نضجًا فتدمج هذا التقييم مباشرة في أداة إدارة خارطة الطريق لديها (Notion وAirtable وJira) لربطه بكامل برنامج CRO.
منهجية RICES ليست صيغة سحرية تتخذ القرار بدلًا عنك. إنها أداة انضباط جماعي، تُجبر كل فكرة على إثبات قيمتها عبر خمسة أبعاد قبل تعبئة موارد التطوير لديك. وعند استخدامها بانتظام، تحوّل خارطة طريق CRO من مجرد قائمة رغبات إلى محفظة استثمارات حقيقية، مرتّبة وفق القيمة التي تخلقها فعليًا لعملك.