
Als je Data Analyst, Product Manager of Growth Marketer bent, heb je deze situatie misschien al meegemaakt: je lanceert een veelbelovende A/B test en wacht wekenlang op resultaten… die uiteindelijk niet significant blijken. Of erger nog, je ziet cijfers die vlak lijken met de ene rekenmethode, maar die plotseling significant worden zodra je van statistische aanpak wisselt. Ondertussen loop je potentieel waardevolle conversies mis, of laat je een ondermaats presterende variant je omzet aantasten.
Tegenwoordig bieden de meeste A/B Test-tools op de markt (zoals Kameleoon, AB Tasty, VWO of Optimizely) een bayesiaanse aanpak naast de klassieke frequentistische methode. Sommige hebben zelfs de omgekeerde weg afgelegd, zoals AB Tasty, dat eerst uitsluitend bayesiaans was voordat het de frequentistische methode weer opnam in zijn rapporten. Maar waarom deze evoluties? Bij Welyft, als CRO-expertbureau, merken we vaak dat teams moeite hebben om de keuze voor de ene statistische methode boven de andere te onderbouwen.
In dit artikel overladen we je niet met wiskundige formules. Ons doel is om je te helpen de mechanismen achter beide methodes te begrijpen, zodat je de methode kunt kiezen die het beste past bij jouw context, verkeer en businessdoelstellingen.
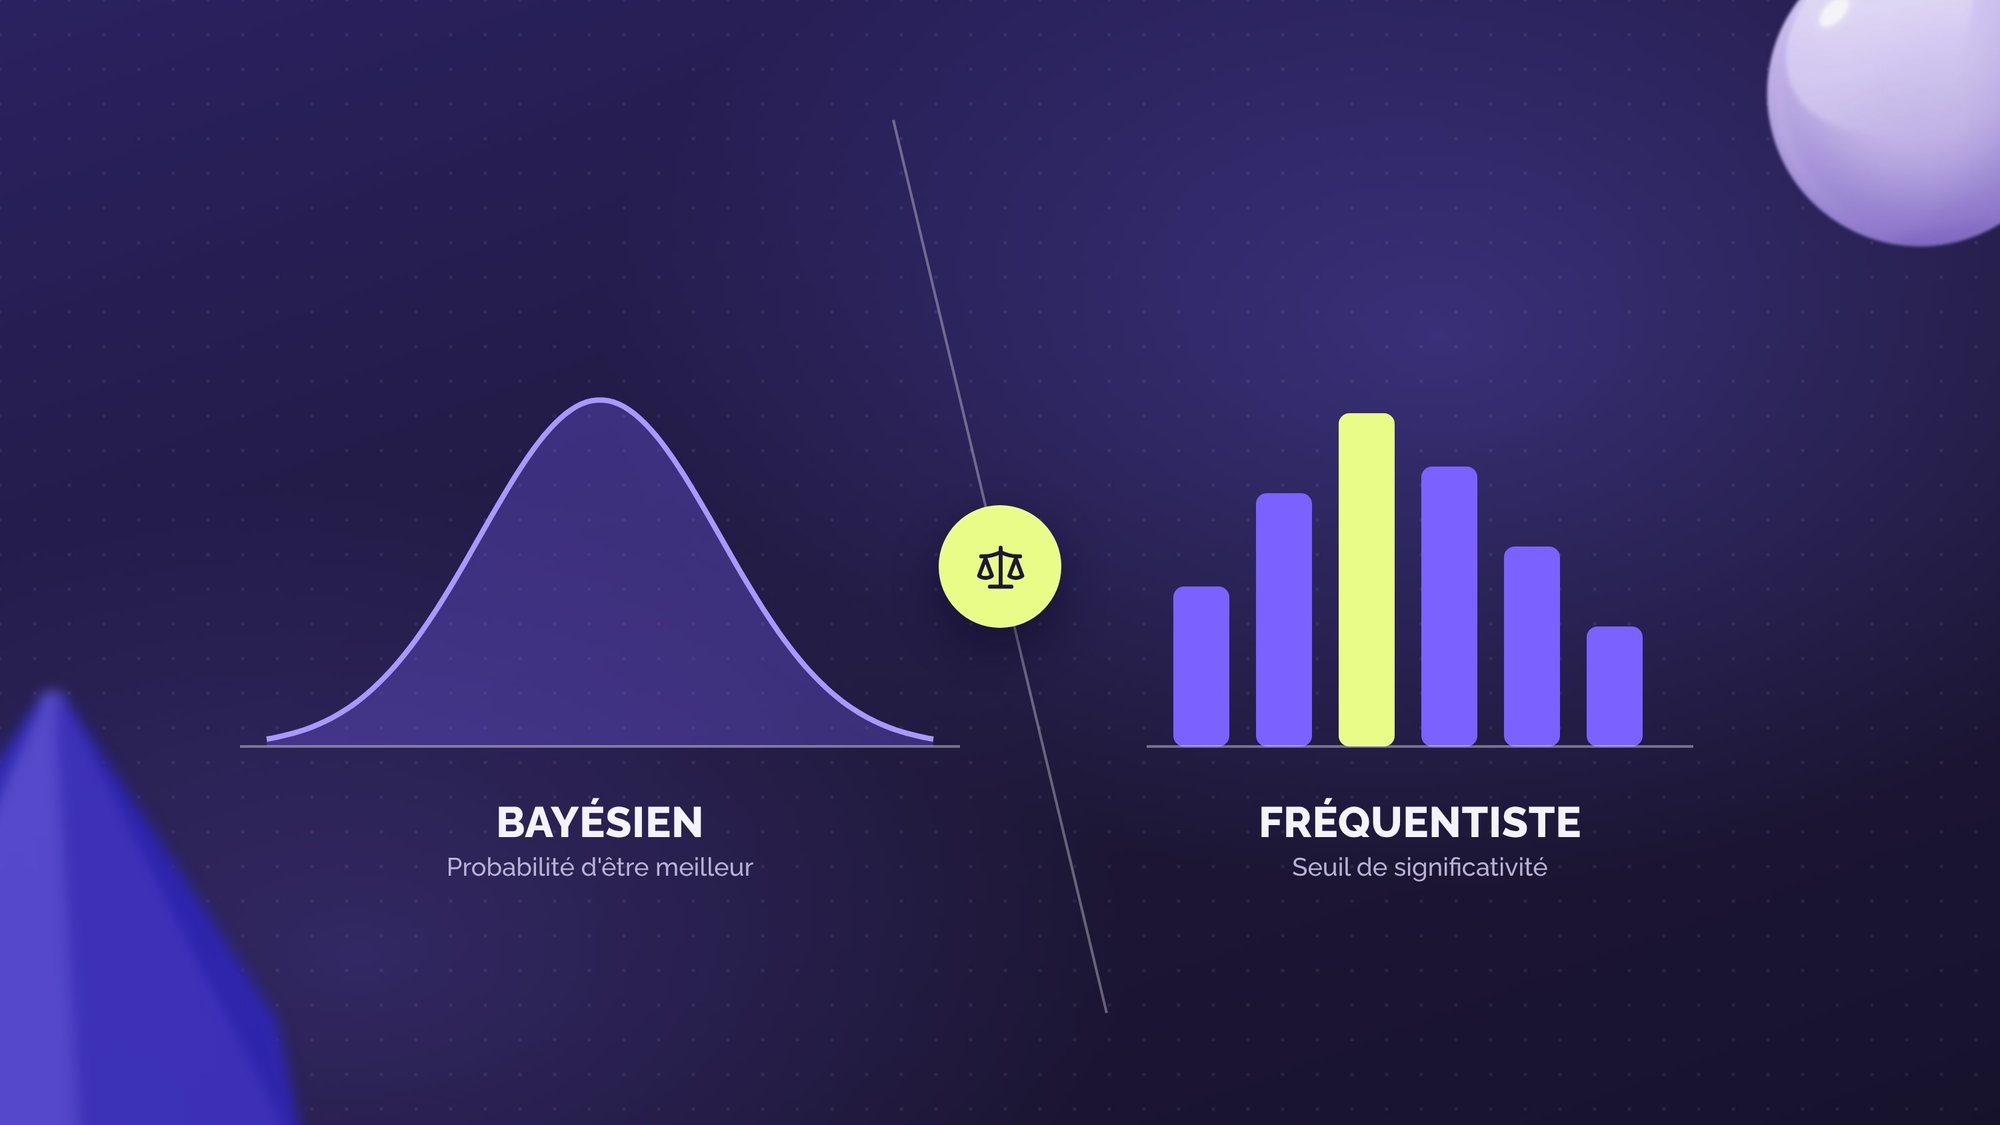
Wat is nu echt het verschil tussen de frequentistische en de bayesiaanse aanpak?
Om goed te begrijpen wat er op het spel staat, moet je de filosofie achter de twee grote statistische scholen doorgronden.
De “Frequentistische” aanpak
De frequentistische methode is de traditionele aanpak, degene die je op school leert. De naam komt van het concept “frequentie”, waarbij de kans op een gebeurtenis overeenkomt met hoe vaak deze zou optreden als je het experiment oneindig vaak zou herhalen.
Bij een A/B Test “denk je omgekeerd”. De methode gaat uit van een principe genaamd de “nulhypothese”. Dat wil zeggen dat je veronderstelt dat er absoluut geen verschil is tussen versie A (de “originele” versie of controle) en versie B (variant). Het doel is vervolgens om een vooraf bepaald datavolume te verzamelen om te bewijzen dat deze hypothese onjuist is, en zo aan te tonen dat de doorgevoerde wijziging statistisch significant is. Geen zorgen, deze berekening doe je niet met de hand, er bestaan talloze tools hiervoor en we hebben de beste calculators op een rijtje gezet in dit specifieke artikel.
De belangrijkste indicatoren zijn de p-waarde (die de kans meet dat het waargenomen verschil aan toeval te wijten is) en het betrouwbaarheidsinterval (wat betekent dat als je deze test talloze keren zou herhalen, 90% van deze intervallen de werkelijke winst zouden bevatten). Het is uiteindelijk een binaire methode: ofwel is het waargenomen verschil puur toeval, ofwel wordt het bevestigd.
De rechtbank-analogie: Het is als een rechtszaak. Versie B is “onschuldig” aan elke vorm van superioriteit totdat je voldoende bewijs hebt verzameld om het tegendeel aan te tonen.
De “Bayesiaanse” aanpak
De bayesiaanse aanpak (gebaseerd op de stelling van de Britse wiskundige Thomas Bayes) werkt zoals een mens die een beslissing neemt. Ze integreert bestaande kennis en werkt haar kansen in real time bij telkens wanneer een nieuwe gebruiker met je test interageert. In plaats van te proberen een absolute waarheid te bewijzen, geeft deze methode je een intuïtief en concreet antwoord: “Hoe groot is de kans dat variant B beter is dan A?”
De belangrijkste indicatoren zijn de winstkans (rechtstreeks uitgedrukt als percentage kans dat B wint van A) en het geloofwaardigheidsinterval (dat je concreet vertelt: “er is 90% kans dat je winst tussen +1% en +3% ligt”).
De sportweddenschap-analogie: Stel je voor dat je wedt op een tennismatch. Naarmate de sets vorderen en spelers punten scoren, pas je je vertrouwen in de uiteindelijke winnaar continu aan. Je wacht niet tot het einde van de wedstrijd om te begrijpen wie domineert, je werkt je “overtuiging” continu bij op basis van wat er op de baan gebeurt.
Beide methodes beantwoorden niet dezelfde vraag. De frequentistische methode probeert vast te stellen of er een werkelijk verschil bestaat tussen A en B, dat is een vraag van bestaan. De bayesiaanse methode geeft direct aan of variant B beter is dan A en met welke waarschijnlijkheid, dat is een vraag van beslissing. Het is vaak dit nuanceverschil dat teams ontgaat en dat leidt tot verkeerde interpretaties van de resultaten.
Wat zijn de belangrijkste indicatoren van de frequentistische en bayesiaanse methodes?
Dit is meestal het punt waarop het ingewikkeld wordt en het technisch jargon de overhand neemt. Simpel gezegd beantwoorden frequentistische en bayesiaanse statistiek gewoon niet dezelfde vraag.
Hier is een duidelijke vergelijking om concreet te begrijpen wat je leest:
| Wat je wilt weten | Frequentistische methode | Bayesiaanse methode |
|---|---|---|
| De vraag waarop het algoritme antwoord geeft | “Is het verschil tussen A en B te wijten aan toeval?” | “Hoe groot is de kans dat variant B beter presteert dan A?” |
| De belangrijkste succesindicator |
De P-value In tegenstelling tot wat vaak wordt gedacht, is dit niet de kans op succes, maar de kans om resultaten te behalen die minstens zo uitgesproken zijn als de waargenomen resultaten. Ze dient om het gewicht van het toeval te meten: hoe lager de P-value, hoe sterker de hypothese van gelijkheid tussen A en B wankelt ten gunste van een reëel verschil. Daarom wordt ze vaak weergegeven als “1 - Pvalue”, waardoor een index verandert in een intuïtiever statistisch betrouwbaarheidspercentage. |
De winstkans Kort gezegd: dit is direct en intuïtief. De tool zegt letterlijk: “Er is 95% kans dat je nieuwe productpagina beter converteert dan de huidige” |
| De schatting van je potentiële winst |
Het betrouwbaarheidsinterval Pas op voor deze valkuil! Het geeft je niet de kans dat je winst binnen dit interval valt. Het beoordeelt de betrouwbaarheid op lange termijn. Een betrouwbaarheidsinterval van 90% betekent bijvoorbeeld dat als je dit hele proces (gegevens verzamelen en het interval berekenen) vele keren zou herhalen, 90% van die intervallen het werkelijke percentage zouden bevatten. |
Het geloofwaardigheidsinterval Dit is een directe en begrijpelijke schatting voor je business. Een geloofwaardigheidsinterval van 90% betekent bijvoorbeeld dat er 90% kans is dat de werkelijke winst binnen dit interval valt. |
| De regel voor steekproefomvang |
Vaste omvang Je moet het aantal benodigde bezoekers berekenen voordat je de test start en niets wijzigen totdat dit aantal is bereikt |
Flexibele omvang Het algoritme wordt continu bijgewerkt bij elk nieuw bezoek. Je hoeft vooraf geen vaste steekproefomvang te respecteren |
| Tussentijds observeren (Data peeking) |
Strikt verboden Een beslissing nemen voordat de test is afgelopen, vervalst de analyse en vergroot het risico dat je een valse winnaar uitrolt |
Toegestaan Je kunt de trends dagelijks volgen. Ideaal om een variant direct stop te zetten als die schadelijk blijkt voor je verkoop. |
Uiteindelijk kan het frequentistische vocabulaire (zoals de beroemde P-value) contra-intuïtief zijn voor iedereen en brengt het teams er vaak toe de resultaten verkeerd te interpreteren. Zijn striktheid heeft echter een verdienste: het laat geen ruimte voor interpretatie. Onder de vastgestelde betrouwbaarheidsdrempel is het oordeel onherroepelijk, de test blijft niet-concludent, punt uit.
Deze discipline strekt zich zelfs uit tot de voorbereidingsfase. Door de duur van de test te berekenen voordat je hem start, structureer je op natuurlijke wijze je experimentatieroadmap, voorkom je overlappingen tussen tests op hetzelfde domein en weet je altijd wanneer je de volgende kunt starten.
Omgekeerd sluit het Bayesiaanse vocabulaire aan bij de realiteit van ons vakgebied: het kwantificeert een risico en schat een financiële winst in, wat de besluitvorming in vergaderingen aanzienlijk vergemakkelijkt. Deze flexibiliteit heeft echter een prijs. Niets weerhoudt je ervan een variant tot winnaar uit te roepen op basis van een nog fragiele winstkans. Het risico is des te reëler bij kleine effecten, waar het geloofwaardigheidsinterval breed blijft en tijd nodig heeft om te stabiliseren, zelfs wanneer de winstkans al veelbelovend lijkt.
Kun je je resultaten echt in real time lezen?
Het grote nadeel van de frequentistische aanpak is de rigiditeit ervan. Als je onderweg naar je resultaten kijkt (dit heet "Data Peeking") en een beslissing neemt voordat de vooraf berekende steekproefdrempel is bereikt, vervals je je analyse.
De Bayesiaanse aanpak kan daarentegen een echte versneller van beslissingen zijn, maar deze flexibiliteit rechtvaardigt geen overhaasting. Voordat je een test stopzet, zorg er altijd voor dat de waargenomen trend duidelijk is en over meerdere dagen is bevestigd. Een nieuwigheidseffect, seizoensgebondenheid of een eenvoudige tijdelijke schommeling kan gemakkelijk een vals alarm geven, vooral wanneer het geloofwaardigheidsinterval nog instabiel is. Zodra aan deze voorwaarden is voldaan, kun je een test stopzetten als deze je verkoop doet dalen, of de winnende versie uitrollen zonder weken te wachten vanwege een vaste steekproefomvang, zodra je een geruststellende succeskans behaalt met een smaller geloofwaardigheidsinterval.
Welke methode voor welke context?
Er bestaat geen “slechte” methode, alleen methodes die verkeerd worden toegepast op een gegeven context. Hier lees je hoe wij aanraden ze te gebruiken bij jouw e-commerce- of leadgen-vraagstukken.
Wanneer gebruik je de frequentistische methode?
Geef hieraan de voorkeur wanneer je werkt aan belangrijke structurele veranderingen of hoogrisico-tests waarbij een verkeerde beslissing erg duur zou uitpakken. Je hebt dan de “wetenschappelijke striktheid” nodig die vereist dat je wacht tot het einde van de test om te concluderen, om de risico's zoveel mogelijk te beperken.
- Voorbeeld 1: De volledige herziening van een aankooptunnel. Stel je voor dat je het design van alle stappen van je checkout verandert. Als je het mis hebt, zal het omzetverlies enorm zijn. Je hebt dus de striktheid van de frequentistische methode nodig om 100% zeker te zijn van je statistische significantie voordat je je ontwikkelaars een maand lang aan het werk zet.
- Voorbeeld 2: Op sites met zeer veel verkeer, waar de vereiste steekproef al binnen enkele dagen wordt bereikt. Het datavolume maakt het hier mogelijk om te profiteren van de striktheid van het frequentistische model zonder de gebruikelijke wachttijden te ondergaan, waardoor je dezelfde reactiesnelheid krijgt als bij de Bayesiaanse methode.
Aanbevolen tool voor de frequentistische methode: De Welyft-calculator
Wanneer gebruik je de Bayesiaanse methode?
Ze is ideaal voor dagelijkse wendbaarheid en iteratieve tests. Ze maakt het mogelijk eerder te stoppen als een variant duidelijk beter presteert en de resultaten veel intuïtiever te interpreteren.
- Voorbeeld 1: Op pagina's met weinig verkeer (bijvoorbeeld B2B of een nichemarkt). Hier zou het verkrijgen van de door de frequentistische methode vereiste steekproefomvang 6 maanden duren. Met de Bayesiaanse methode kun je veel sneller een betrouwbare succeskans bepalen.
- Voorbeeld 2: Bij micro-optimalisaties (bijvoorbeeld wording, geruststellende elementen...). Want in dit geval zijn de implementatiekosten laag. Als het geloofwaardigheidsinterval een potentiële winst tussen +1% en +3% aangeeft, kun je itereren en uitrollen zonder op een absolute validatie te wachten.
- Voorbeeld 3: Bij korte promotiecampagnes (bijvoorbeeld uitverkoop, black friday...). Hier is de tijd beperkt en de Bayesiaanse methode stelt je in staat om over te schakelen naar de winnende variant zodra er een sterke trend zichtbaar wordt, waardoor je de directe winst maximaliseert.
Aanbevolen tool voor de Bayesiaanse methode: De Welyft-calculator
Wat is de echte CRO-expertise in dit alles?
De juiste tool op het juiste moment inzetten, dat is de echte CRO-expertise. Maar deze flexibiliteit in keuze mag niet ontaarden in methodologische vaagheid. De methode moet worden bepaald vóór de start van de test, nooit tijdens het traject. Van statistische aanpak wisselen halverwege een experiment, of schipperen tussen beide op basis van de resultaten die je het beste uitkomen, bemoeilijkt ernstig de historisering van je resultaten en ondermijnt de betrouwbaarheid van je conclusies.
Onthoud het belangrijkste. De frequentistische aanpak biedt je nauwkeurigheid, ideaal voor beslissingen met grote impact. De bayesiaanse aanpak biedt je wendbaarheid, perfect om snel te itereren en in real time te beslissen. Toch is deze niet geschikt voor non-inferioriteitstests, aangezien hij alleen aangeeft of een variant beter is dan een andere, zonder te kunnen bevestigen dat deze niet significant slechter is.
Bij Welyft kiezen we als CRO-experts altijd voor de methode die de resultaten dient, niet die welke in de mode is. Want een goede CRO-beslissing is vooral de juiste aanpak op basis van context, traffic en businessdoelstellingen.