
Wenn Sie Data Analyst, Product Manager oder Growth Marketer sind, haben Sie diese Situation vielleicht schon erlebt: Sie starten einen vielversprechenden A/B Test und warten wochenlang auf Ergebnisse… die sich letztendlich als nicht signifikant erweisen. Oder schlimmer noch, Sie beobachten Zahlen, die mit einer Berechnungsmethode flach erscheinen, aber beim Wechsel des statistischen Ansatzes plötzlich signifikant werden. In der Zwischenzeit verlieren Sie potenziell wertvolle Conversions oder lassen eine unterperformende Variante Ihren Umsatz verschlechtern.
Heute bieten die meisten A/B-Test-Tools auf dem Markt (wie Kameleoon, AB Tasty, VWO oder Optimizely) einen bayesianischen Ansatz als Ergänzung zur klassischen frequentistischen Methode an, manche haben sogar den umgekehrten Weg eingeschlagen, wie AB Tasty, das zunächst ausschließlich bayesianisch war, bevor es die frequentistische Methode wieder in seine Reports integrierte. Doch warum diese Entwicklungen? Bei Welyft, als Expertenagentur für CRO, stellen wir häufig fest, dass Teams Schwierigkeiten haben, die Wahl einer statistischen Methode gegenüber einer anderen zu begründen.
In diesem Artikel werden wir Sie nicht mit mathematischen Formeln überhäufen. Unser Ziel ist es, Ihnen zu helfen, die Mechanik beider Methoden zu verstehen, damit Sie diejenige wählen können, die am besten zu Ihrem Kontext, Ihrem Traffic und Ihren Geschäftszielen passt.
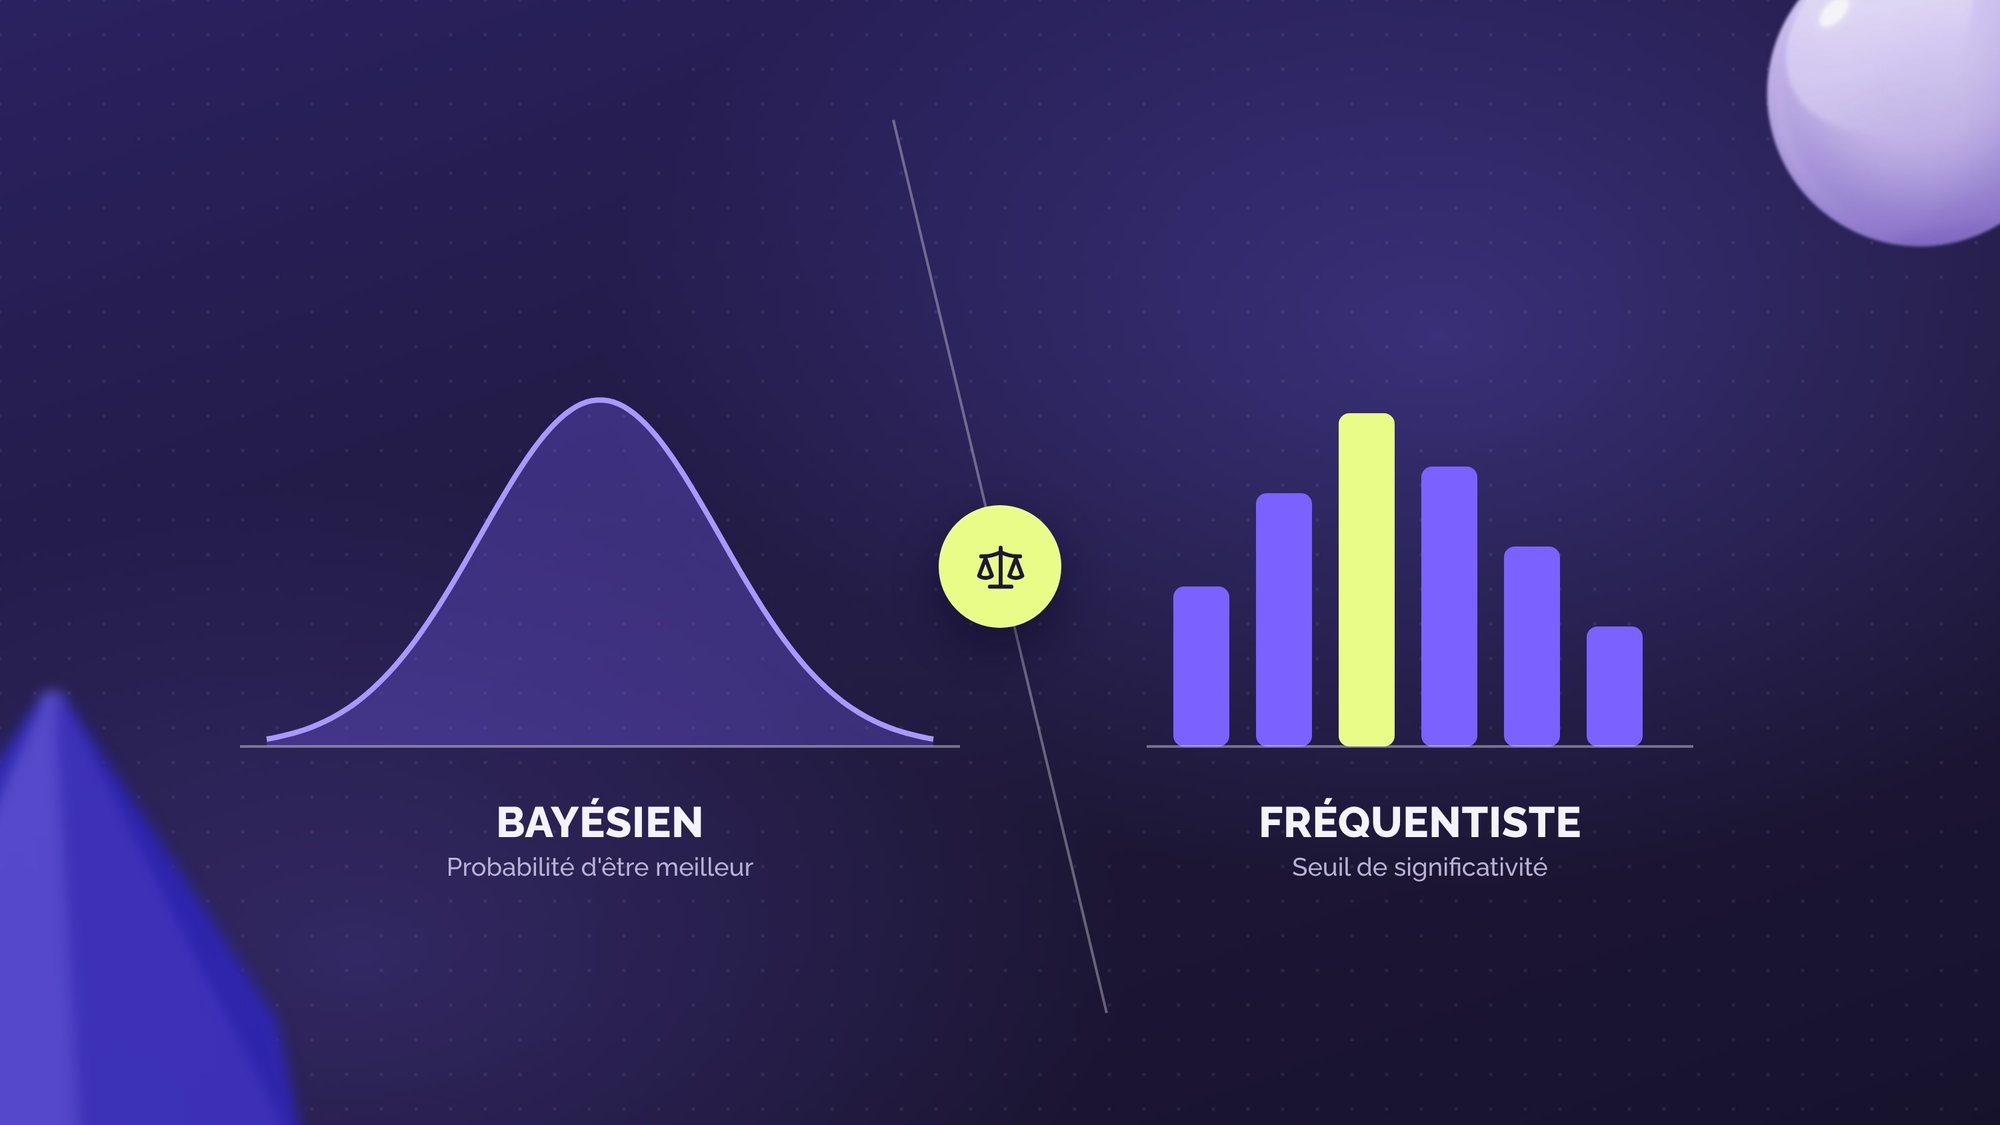
Was unterscheidet den frequentistischen Ansatz wirklich vom bayesianischen Ansatz?
Um wirklich zu verstehen, worum es geht, muss man die Philosophie hinter den beiden großen statistischen Schulen erfassen.
Der „Frequentistische“ Ansatz
Die frequentistische Methode ist der traditionelle Ansatz, den man in der Schule lernt. Sie verdankt ihren Namen dem Konzept der „Häufigkeit“, wobei die Wahrscheinlichkeit eines Ereignisses der Häufigkeit entspricht, mit der es auftreten würde, wenn man das Experiment unendlich oft wiederholen würde.
Bei einem A/B Test „denkt man rückwärts“. Die Methode geht von einem Prinzip aus, das „Nullhypothese“ genannt wird. Das heißt, man geht davon aus, dass es absolut keinen Unterschied zwischen Version A (der sogenannten „Original“- oder „Kontroll“-Version) und Version B (Variante) gibt. Ihr Ziel ist es dann, ein vordefiniertes Datenvolumen anzusammeln, um zu beweisen, dass diese Hypothese falsch ist, und so zu zeigen, dass die vorgenommene Änderung statistisch signifikant ist. Keine Sorge, diese Berechnung wird nicht von Hand durchgeführt, es gibt zahlreiche Tools dafür, und wir haben die besten Rechner in diesem speziellen Artikel aufgelistet.
Ihre Schlüsselkennzahlen sind der p-Wert (der die Wahrscheinlichkeit misst, dass der beobachtete Unterschied auf Zufall beruht) und das Konfidenzintervall (das bedeutet, dass wenn Sie diesen Test viele Male wiederholen würden, 90% dieser Intervalle den wahren Gewinn enthalten würden). Es handelt sich letztlich um eine binäre Methode: Entweder ist der beobachtete Unterschied ein reiner Zufall, oder er wird bestätigt.
Die Gerichtsanalogie: Es ist wie ein Prozess. Version B ist „unschuldig“ in Bezug auf jede Überlegenheit, solange Sie nicht genügend Beweise gesammelt haben, um das Gegenteil zu zeigen.
Der „Bayesianische“ Ansatz
Der bayesianische Ansatz (nach dem Theorem des britischen Mathematikers Thomas Bayes) funktioniert wie ein Mensch bei einer Entscheidungsfindung. Er integriert bestehendes Wissen und aktualisiert seine Wahrscheinlichkeiten in Echtzeit, jedes Mal wenn ein neuer Nutzer mit Ihrem Test interagiert. Anstatt eine absolute Wahrheit beweisen zu wollen, gibt Ihnen diese Methode eine intuitive und konkrete Antwort: „Wie hoch ist die Wahrscheinlichkeit, dass Variante B besser ist als A?“
Ihre Schlüsselkennzahlen sind die Gewinnwahrscheinlichkeit (direkt ausgedrückt als Prozentsatz der Chancen, dass B gegen A gewinnt) und das Glaubwürdigkeitsintervall (das Ihnen konkret sagt: „Es besteht eine 90%ige Chance, dass sich Ihr Gewinn zwischen +1% und +3% bewegt“).
Die Sportwetten-Analogie: Stellen Sie sich vor, Sie wetten auf ein Tennismatch. Während die Sätze voranschreiten und die Spieler Punkte erzielen, passen Sie Ihr Vertrauen in den endgültigen Sieger an. Sie warten nicht bis zum Ende des Spiels, um zu verstehen, wer dominiert, sondern aktualisieren Ihre „Überzeugung“ kontinuierlich entsprechend den Ereignissen auf dem Platz.
Die beiden Methoden beantworten nicht dieselbe Frage. Der frequentistische Ansatz versucht zu bestimmen, ob ein realer Unterschied zwischen A und B existiert – das ist eine Existenzfrage. Der bayesianische Ansatz zeigt direkt, ob Variante B besser ist als A und mit welcher Wahrscheinlichkeit – das ist eine Entscheidungsfrage. Oft entgeht Teams genau diese Nuance, was zu falschen Interpretationen der Ergebnisse führt.
Was sind die Schlüsselkennzahlen der frequentistischen und bayesianischen Methoden?
In der Regel wird es genau hier kompliziert, und der Fachjargon übernimmt die Oberhand. Vereinfacht gesagt beantworten die frequentistische Statistik und die bayesianische Statistik schlichtweg nicht dieselbe Frage.
Hier ist ein übersichtlicher Vergleich, um zu verstehen, was Sie konkret lesen:
| Was Sie wissen möchten | Frequentistische Methode | Bayessche Methode |
|---|---|---|
| Die Frage, die der Algorithmus beantwortet | „Ist der beobachtete Unterschied zwischen A und B auf Zufall zurückzuführen?“ | „Wie hoch ist die Wahrscheinlichkeit, dass Variante B besser ist als A?“ |
| Der zentrale Erfolgsindikator |
Der P-Wert Entgegen der verbreiteten Annahme handelt es sich nicht um die Erfolgswahrscheinlichkeit, sondern um die Wahrscheinlichkeit, Ergebnisse zu erhalten, die mindestens so ausgeprägt sind wie die beobachteten. Er dient dazu, den Einfluss des Zufalls zu messen: Je niedriger der P-Wert, desto mehr bricht die Annahme einer Gleichheit zwischen A und B zugunsten eines echten Unterschieds zusammen. Deshalb wird er oft in Form von „1 - P-Wert“ dargestellt, wodurch ein Index in eine intuitivere statistische Konfidenzrate umgewandelt wird. |
Die Gewinnwahrscheinlichkeit Konkret gesagt: Sie ist direkt und intuitiv. Das Tool sagt Ihnen buchstäblich: „Es besteht eine Wahrscheinlichkeit von 95 %, dass Ihre neue Produktseite besser konvertiert als die aktuelle“ |
| Die Schätzung Ihrer potenziellen Gewinne |
Das Konfidenzintervall Vorsicht vor der Falle! Es gibt Ihnen nicht die Wahrscheinlichkeit an, dass Ihr Gewinn in diesem Intervall liegt. Es bewertet die langfristige Zuverlässigkeit. Ein Konfidenzintervall von 90 % bedeutet beispielsweise, dass bei wiederholter Durchführung dieses gesamten Prozesses (Datenerhebung und Berechnung des Intervalls) 90 % dieser Intervalle die tatsächliche Rate enthalten würden. |
Das Glaubwürdigkeitsintervall Es ist eine direkte und für Ihr Geschäft verständliche Schätzung. Ein Glaubwürdigkeitsintervall von 90 % bedeutet beispielsweise, dass eine Wahrscheinlichkeit von 90 % besteht, dass der tatsächliche Gewinn in diesem Intervall liegt. |
| Die Stichprobenregel |
Feste Größe Sie müssen die erforderliche Besucherzahl vor dem Start des Tests berechnen und dürfen nichts ändern, bis diese Zahl erreicht ist |
Flexible Größe Der Algorithmus aktualisiert sich bei jedem neuen Besuch kontinuierlich. Sie müssen vorab keine feste Stichprobengröße einhalten |
| Die Beobachtung während des Tests (Data Peeking) |
Strikt untersagt Eine Entscheidung vor Testende zu treffen, verfälscht die Analyse und erhöht das Risiko, einen falschen Gewinner auszurollen |
Erlaubt Sie können die Trends tagesaktuell verfolgen. Ideal, um eine Variante sofort zu stoppen, wenn sie sich als schädlich für Ihre Verkäufe erweist. |
Letztlich kann das frequentistische Vokabular (wie der berühmte P-Wert) für jeden kontraintuitiv sein und verleitet Teams oft dazu, die Ergebnisse falsch zu interpretieren. Seine Strenge hat jedoch einen Vorteil: Sie lässt keinerlei Interpretationsspielraum. Unterhalb der festgelegten Konfidenzschwelle ist das Urteil unanfechtbar, der Test bleibt nicht schlüssig, Punkt.
Diese Disziplin erstreckt sich sogar auf die Vorbereitungsphase. Indem Sie die Testdauer vor dem Start berechnen, strukturieren Sie Ihre Experimentier-Roadmap auf natürliche Weise, vermeiden Überschneidungen zwischen Tests im selben Bereich und wissen immer, wann Sie den nächsten starten können.
Umgekehrt stimmt das bayessche Vokabular mit der Realität unserer Berufe überein: Es quantifiziert ein Risiko und schätzt einen finanziellen Gewinn, was die Entscheidungsfindung in Meetings erheblich erleichtert. Diese Flexibilität hat jedoch ihren Preis. Keine Schutzvorkehrung hindert Sie daran, eine Variante auf Basis einer noch unsicheren Gewinnwahrscheinlichkeit als Gewinner zu erklären. Das Risiko ist bei kleinen Effekten umso realer, wo das Glaubwürdigkeitsintervall breit bleibt und lange braucht, um sich zu stabilisieren, selbst wenn die Gewinnwahrscheinlichkeit bereits vielversprechend erscheint.
Kann man seine Ergebnisse wirklich in Echtzeit lesen?
Der große Nachteil des frequentistischen Ansatzes ist seine Starrheit. Wenn Sie Ihre Ergebnisse während des Tests betrachten (das sogenannte „Data Peeking“) und eine Entscheidung treffen, bevor die vorab berechnete Stichprobenschwelle erreicht ist, verfälschen Sie Ihre Analyse.
Der bayessche Ansatz kann hingegen ein echter Entscheidungsbeschleuniger sein, aber diese Flexibilität entschuldigt keine Überstürzung. Bevor Sie einen Test stoppen, vergewissern Sie sich immer, dass der beobachtete Trend klar ist und sich über mehrere Tage bestätigt. Ein Neuheitseffekt, Saisonalität oder eine einfache punktuelle Schwankung können leicht einen falschen Alarm auslösen, besonders wenn das Glaubwürdigkeitsintervall noch instabil ist. Sobald diese Bedingungen erfüllt sind, können Sie einen Test stoppen, wenn er Ihre Verkäufe einbrechen lässt, oder die gewinnende Version ausrollen, ohne wochenlang wegen einer festen Stichprobengröße zu warten, sobald Sie eine beruhigende Erfolgswahrscheinlichkeit mit einem engeren Glaubwürdigkeitsintervall erhalten.
Welche Methode für welchen Kontext?
Es gibt keine „schlechte“ Methode, es gibt nur Methoden, die in einem bestimmten Kontext falsch angewendet werden. So empfehlen wir, sie bei Ihren E-Commerce- oder Lead-Gen-Problemstellungen einzusetzen.
Wann sollte man die frequentistische Methode verwenden?
Sie ist zu bevorzugen, wenn Sie an größeren strukturellen Änderungen oder risikoreichen Tests arbeiten, bei denen ein Fehlentscheid sehr teuer werden würde. Sie benötigen diese „wissenschaftliche Strenge“, die verlangt, das Testende abzuwarten, bevor man eine Schlussfolgerung zieht, um die Risiken maximal zu begrenzen.
- Beispiel 1: Die komplette Neugestaltung eines Kauftunnels. Stellen Sie sich vor, Sie ändern das Design aller Schritte Ihres Checkouts. Wenn Sie sich irren, wird der Umsatzverlust enorm sein. Sie benötigen daher die Strenge des frequentistischen Ansatzes, um zu 100 % sicher zu sein, bevor Sie Ihre Entwickler für ein monatelanges Projekt einsetzen.
- Beispiel 2: Auf stark frequentierten Websites, bei denen die erforderliche Stichprobe bereits in wenigen Tagen erreicht wird. Das Datenvolumen ermöglicht es hier, von der Strenge des frequentistischen Modells zu profitieren, ohne die üblichen Wartezeiten in Kauf nehmen zu müssen – und so die Reaktivität der bayesschen Methode zu erreichen.
Empfohlenes Tool für die frequentistische Methode: Der Welyft-Rechner
Wann sollte man die bayessche Methode verwenden?
Sie ist ideal für die tägliche Agilität und iterative Tests. Sie ermöglicht es, früher aufzuhören, wenn eine Variante deutlich besser abschneidet, und die Ergebnisse viel intuitiver zu interpretieren.
- Beispiel 1: Bei Seiten mit geringem Traffic (z. B. B2B oder Nischenmärkte). Hier würde es 6 Monate dauern, die vom Frequentismus geforderte Stichprobengröße zu erreichen. Der bayessche Ansatz ermöglicht es Ihnen, viel schneller eine zuverlässige Erfolgswahrscheinlichkeit zu ermitteln.
- Beispiel 2: Bei Mikro-Optimierungen (z. B. Wording, Vertrauenselemente…). Denn in diesem Fall sind die Implementierungskosten gering. Wenn das Glaubwürdigkeitsintervall einen potenziellen Gewinn zwischen +1 % und +3 % anzeigt, können Sie iterieren und ausrollen, ohne auf eine absolute Bestätigung zu warten.
- Beispiel 3: Bei kurzen Werbeaktionen (z. B. Schlussverkäufe, Black Friday…). Hier ist die Zeit knapp bemessen, und die bayessche Methode ermöglicht es Ihnen, auf die gewinnende Variante umzuschalten, sobald sich ein starker Trend abzeichnet, um den unmittelbaren Gewinn zu maximieren.
Empfohlenes Tool für die bayessche Methode: Der Welyft-Rechner
Quelle est la vraie expertise CRO dans tout ça ?
Utiliser le bon outil au bon moment, c'est ça la vraie expertise CRO mais cette flexibilité de choix ne doit pas se transformer en flou méthodologique. La méthode doit être décidée avant le lancement du test, jamais en cours de route. Changer d'approche statistique au milieu d'une expérimentation, ou jongler entre les deux selon les résultats qui vous arrangent, erschwert ernsthaft die Historisierung Ihrer Ergebnisse und schwächt die Zuverlässigkeit Ihrer Schlussfolgerungen.
Merken Sie sich das Wesentliche. Der Frequentist bietet Ihnen Genauigkeit, ideal für Entscheidungen mit hohem Einsatz. Der Bayesianische Ansatz bietet Ihnen Agilität, perfekt, um schnell zu iterieren und in Echtzeit zu entscheiden. Allerdings ist er nicht für Nicht-Unterlegenheitstests geeignet, da er lediglich angibt, ob eine Variante besser ist als eine andere, ohne bestätigen zu können, dass sie nicht signifikant schlechter ist.
Bei Welyft wählen wir als CRO-Experten immer die Methode, die den Ergebnissen dient, nicht diejenige, die gerade angesagt ist. Denn eine gute CRO-Entscheidung ist vor allem der richtige Ansatz entsprechend eines Kontexts, eines Traffics und bestimmter Geschäftsziele.