
Has realizado bien tu trabajo de análisis e ideación: has hablado con tus clientes, has desmenuzado tus datos, has intercambiado con diferentes equipos para obtener sus insights. En resumen, has identificado una serie de recorridos que optimizar, de funcionalidades que probar, en definitiva, decenas y decenas de hipótesis que validar. Ahora hay que enfrentarse a la realidad de la experimentación: no todo se puede testear. Falta de tráfico, de recursos de desarrollo, de diseño o de análisis, resistencia de otros equipos, no faltan razones para posponer un test. Y, sin embargo, además de todos estos obstáculos muy reales, podrías complicarte aún más la vida añadiendo una restricción adicional, hacer un solo test a la vez, en nombre de una supuesta pureza estadística que haría sonrojar a un manual escolar, pero palidecer a la mayoría de los profesionales.
Este principio de «un test a la vez», concebido originalmente para proteger la fiabilidad de los resultados, es en realidad el principal freno a tu velocidad de producto: semanas de espera para ti y tus equipos mientras tus competidores avanzan. En tu empresa, la innovación hace cola.
Y, sin embargo, los líderes del sector resolvieron este problema hace tiempo y su enfoque es más accesible de lo que se cree. ¿Piensas que los «usual suspects» del crecimiento digital, Google, Meta, Netflix, Spotify, BlaBlaCar, Leboncoin, ejecutan cientos, a veces miles de tests simultáneamente haciéndolo de uno en uno? Por supuesto que no. Es cierto que estos gigantes cuentan con recursos fuera de lo común, pero eso no explica esos volúmenes: cuando se relaciona ese número de tests con los equipos que los ejecutan, se observa que la palanca es metodológica, no presupuestaria. Más aún cuando algunos de ellos, Google o Netflix por ejemplo, tienen menos plantillas de página que un sitio de e-commerce. Cada página debe necesariamente albergar varios experimentos a la vez, ya que Google Search solo puede optimizar la página de resultados de búsqueda. La regla del «uno a la vez» ya no es una buena práctica. Es una desventaja competitiva.
La pregunta ya no es si hay que ejecutar tus tests en paralelo. Es cómo hacerlo sin comprometer tus datos ni tu producto.
1. Velocidad vs. Miedo a las colisiones
La realidad del negocio
Si un test aislado es estadísticamente deseable, es operativamente paralizante. Cada semana que se pasa esperando a que termine un test antes de lanzar otro es una semana de aprendizaje perdida. A gran escala, eso se traduce en meses de decisiones retrasadas e ingresos perdidos.
Tomemos un caso concreto. Un equipo de producto con un backlog de 50 hipótesis y un ciclo medio de tres semanas por test solo puede validar 17 hipótesis al año en modo secuencial. El mismo equipo, con las salvaguardas adecuadas, puede procesar de cuatro a cinco veces más paralelizando, es decir, la totalidad del backlog y las iteraciones que de ahí se derivan. La diferencia no es marginal: extrapolando a partir de una tasa de aprendizaje del 60%, de la cual un tercio son tests ganadores, la paralelización generaría 30 aprendizajes adicionales, incluidos 10 tests ganadores adicionales y 20 pérdidas evitadas, lo que permite duplicar o incluso triplicar el ROI de un programa de experimentación.
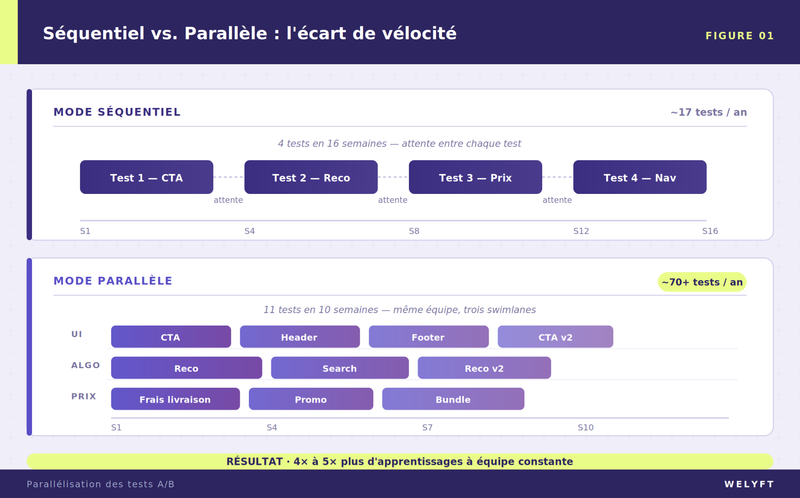
Figura 1: modelización de las diferencias de velocidad entre una hoja de ruta secuencial y una paralelizada
Y esta brecha se amplía con el tiempo. Los equipos que testean más rápido aprenden más rápido. Los que aprenden más rápido iteran más rápido. Y los que iteran más rápido captan una parte desproporcionada del valor en su mercado. Esto no es teórico: es un efecto compuesto que se observa en cada líder digital que ha convertido el testing paralelo en una práctica estándar.
¿Por qué aislar? El miedo a los efectos de interacción
Seamos claros: los efectos de interacción existen. Si pruebas un botón rojo y un fondo rojo al mismo tiempo, corres el riesgo de hacer tu interfaz ilegible para parte de tu audiencia y de invalidar ambos tests. Este tipo de conflicto directo entre dos tests, llamado interacciones antagónicas, puede derivar en experiencias de usuario degradadas y en decisiones de producto basadas en datos falseados.
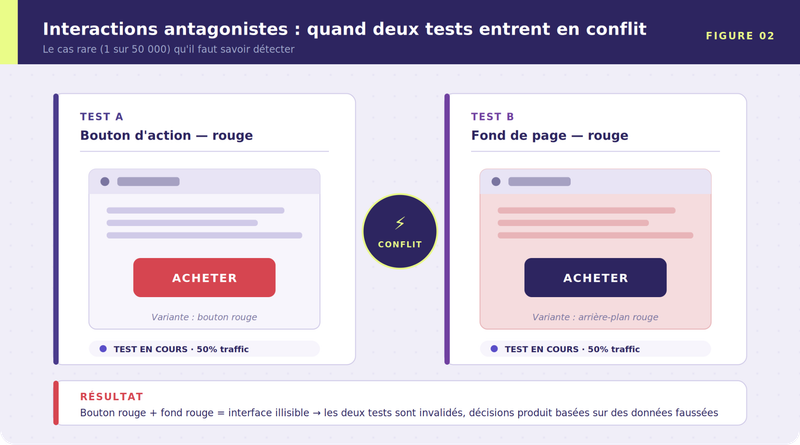
Figura 2: ilustración de interacciones antagónicas entre dos tests paralelizados sobre un mismo elemento
Pero la realidad es que la inmensa mayoría de las interacciones entre tests son inexistentes, y aún menos son significativas. Un estudio realizado por el equipo de experimentación de Microsoft (Kohavi et al.), que analizó cientos de miles de pares de tests simultáneos en Bing y los productos de Microsoft, demostró que las interacciones lo suficientemente importantes como para falsear una decisión de puesta en producción solo ocurren en 1 de cada 50.000 casos.
Uno entre cincuenta mil.
Esta rareza se explica fácilmente: ya es raro detectar un efecto estadísticamente significativo cuando un test se ejecuta solo (Spotify comparte tasas de aprendizaje del 64%). Por lo tanto, es aún menos frecuente que dos tests produzcan simultáneamente un resultado significativo, y más raro todavía que este fenómeno invierta una decisión de puesta en producción. Dicho esto, en los pocos casos en que existen interacciones fuertes y no se supervisan, la probabilidad de elegir la variante equivocada puede llegar a cerca de un tercio de los casos.
La respuesta no es, por tanto, la confianza ciega. Es la implementación de una arquitectura y una gobernanza que orquestan esta paralelización para detectar las interacciones cuando las hay y aprender de ellas.
2. ¿Cómo paralelizar como los programas CRO más reputados?
La arquitectura en capas: una roadmap con swimlanes
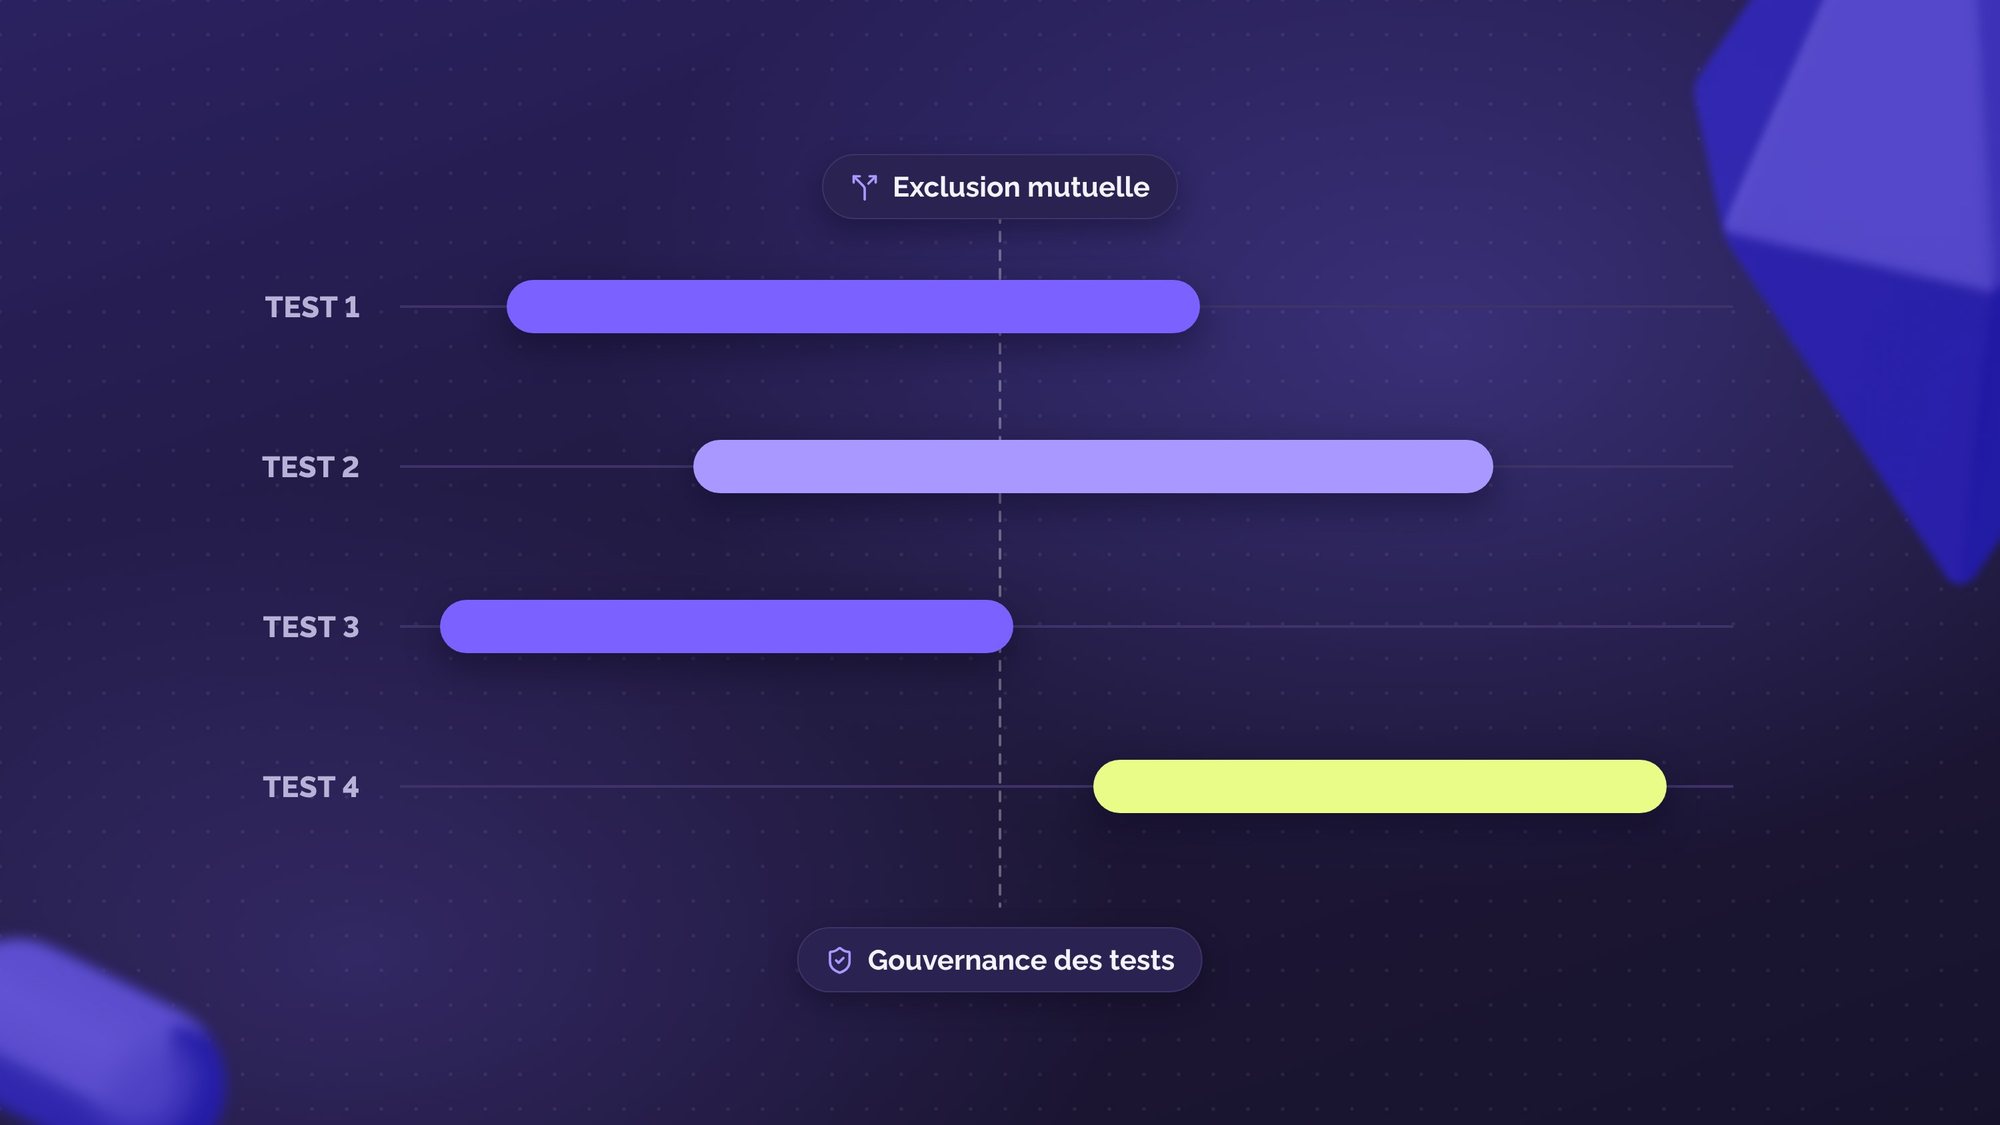
El primer reflejo para paralelizar con seguridad es simple y no requiere ninguna herramienta sofisticada: separar manualmente sus tests por perímetro y por elemento, exactamente como organizaría una roadmap de producto con swimlanes. Cada carril representa un perímetro distinto, permitiendo un mínimo de interacción sin sacrificar la velocidad. A lo largo de su recorrido, un usuario podrá pasar de un carril a otro y, por tanto, de un test a otro. Y como hemos visto, no pasa nada: lo importante es asegurarse de no caer en uno de los raros casos en los que un test falsea la interpretación de los resultados del otro.

Figura 3: Una roadmap con capas distintas entre las páginas y elementos para encuadrar la paralelización
En Welyft, solemos recomendar empezar modelando un primer nivel de carril basado en las plantillas de páginas o pantallas, para distinguir las etapas del recorrido que tienen cada una sus propios retos. Si la velocidad lo requiere, se puede añadir después un segundo nivel basado en una división más libre: por elemento, por tipo de cambio (UI, algorítmico, pricing, etc.), o por segmento de usuario. Mientras dos experimentos no toquen el mismo perímetro, pueden ejecutarse en paralelo sin riesgo de interferencia.
Esta lógica funciona siempre que sus tests se centren en elementos distintos. Si, por el contrario, desea medir las interacciones entre varios elementos de una misma página, puede recurrir a un test multivariante (MVT). Basta con indicarlo en su roadmap haciendo figurar el mismo test en varios carriles simultáneamente.
En una plataforma de e-commerce, esto se traduce concretamente en: un usuario puede participar simultáneamente en un test sobre el wording de la etapa de entrega, en un test sobre el motor de recomendación y en un MVT que mide las interacciones entre el CTA de añadir al carrito, la posición de las reseñas y el layout de las imágenes de producto en la página de producto, sin ninguna colisión, porque cada experimento está asignado a su propio carril en la roadmap.
La lógica de las swimlanes se basa en una hipótesis implícita: lo que usted hace con un usuario no afecta a los demás. En un marketplace (VTC, entrega de comida, plataformas de servicios), esta hipótesis se derrumba, porque la oferta es compartida. Si un test aumenta los pedidos del lado de la demanda, estos pedidos acaparan repartidores que habrían servido al grupo control: ambos grupos interactúan y el resultado observado sobreestima el efecto real. A las interacciones entre tests se añade, por tanto, una segunda familia de interacciones, entre tipos de usuarios, que las swimlanes no cubren. Para controlarla, es necesario integrar desde la roadmap técnicas dedicadas como la randomización por cluster (aislar por zona geográfica) o el switchback testing (alternar los tratamientos en el tiempo).
La automatización como red de seguridad
Esta organización manual basta para la gran mayoría de los programas. Pero cuando el volumen de tests explota, el error humano se convierte en la principal amenaza y ahí es donde entra en juego la automatización.
El primer nivel de automatización, accesible a todos los equipos, consiste en ejecutar verificaciones automáticas sobre los tests activos: unos jobs diarios evalúan todos los pares de tests en curso y señalan las interacciones significativas. El caso raro del 1 entre 50.000 se detecta; todo lo demás funciona libremente. La postura es clara: paralelizar por defecto, supervisar de forma continua, aislar únicamente cuando los datos lo exigen.
Para los programas con un volumen muy alto, es posible un segundo nivel: formalizar la propia arquitectura de la roadmap con mecanismos técnicos (hash-salts distintos por capa, asignación independiente de los usuarios), lo que garantiza el aislamiento por construcción. Pero para la gran mayoría de los equipos, este nivel de inversión no se justifica: organizar bien su roadmap en swimlanes basta para obtener la mayor parte de las ganancias de velocidad.
3. ¿Por qué la técnica no basta?
Todo lo que acabamos de ver, swimlanes, MVT, automatización, es técnicamente accesible. Y sin embargo, muy pocas organizaciones lo logran realmente. ¿Por qué? Porque el verdadero cuello de botella nunca es la herramienta. Es todo lo que debe existir alrededor.
El verdadero problema es organizacional
Cuando varios equipos pueden lanzar tests en paralelo, hace falta que alguien posea las reglas del juego. ¿Quién puede testear qué, en qué capa? ¿Qué constituye un KPI válido? ¿Cuándo un test es lo suficientemente maduro para ser concluido? ¿Quién arbitra cuando dos tests apuntan al mismo segmento? La automatización aplica reglas, no las escribe. Sin una gobernanza clara, la paralelización crea confusión, no valor.
La confianza como motor del cambio
E incluso con reglas claras, queda un obstáculo más insidioso: hacer aceptar estas reglas. Los responsables senior que han construido su instinto sobre resultados aislados a menudo rechazarán las conclusiones derivadas de tests paralelizados, sobre todo las conclusiones desfavorables, por reflejo más que por análisis. «Estos resultados no son fiables, había otros tests en curso» se convierte en un argumento cómodo para ignorar datos incómodos.
Esto es precisamente lo que debe producir la gobernanza: construir la confianza institucional en el marco metodológico es tan importante como construir el propio marco. Esto pasa por pedagogía, resultados reproducibles y una transparencia total sobre la metodología; no por un slide deck más en el comité de dirección.
La importancia de una experiencia dedicada
Poseer la gobernanza y construir esa confianza es un oficio en sí mismo. Las organizaciones que escalan sus programas de experimentación paralela comparten todas un rasgo común: una función dedicada, que posee la metodología, las reglas de gobernanza y la capacitación de los equipos. En Google o Netflix, es un ejército de especialistas internos, un lujo que no es ni realista ni económicamente racional para la mayoría de las empresas francesas y europeas.
Welyft estructura y acelera los programas de sus clientes para ofrecer el máximo de aprendizajes, sin comprometer nunca la fiabilidad de los resultados, desde la arquitectura de tests hasta la gobernanza del programa, pasando por la formación de los responsables de decisión.
Pase a la acción
Paralelizar sus A/B tests no es una apuesta temeraria reservada a los gigantes de la tecnología con millones de usuarios diarios. Es el estándar operativo para todo equipo digital serio en su proceso de crecimiento.
El verdadero reto no es estadístico; el estudio de Microsoft y las prácticas de los mayores experimentadores lo demuestran. Es organizacional. Los equipos que se limitan por miedo a las interacciones no fracasan porque esos temores se hayan confirmado. Fracasan porque nadie poseía la gobernanza y nadie había construido la confianza necesaria para actuar sobre resultados que no «parecen» limpios.
Es exactamente este tipo de reto estadístico, técnico y organizacional el que Welyft acompaña diariamente junto a los equipos digitales franceses y europeos. Desde la arquitectura de experimentación hasta la gobernanza de los programas, pasando por la formación de los responsables de decisión, nuestro enfoque está diseñado para las realidades de su mercado, RGPD incluido.
¿Quiere profundizar antes de lanzarse? Hemos recopilado una revisión completa de los marcos estadísticos, las arquitecturas y las prácticas de los mejores equipos de experimentación del mundo, una guía concreta para estructurar su propio proceso.