
لقد أنجزتم عملكم في التحليل وتوليد الأفكار على أكمل وجه: تحدثتم مع عملائكم، حللتم بياناتكم، وتبادلتم الآراء مع مختلف الأقسام للحصول على رؤاهم. باختصار، حددتم سلسلة من الرحلات التي يجب تحسينها، ووظائف يجب اختبارها، أي عشرات بل عشرات الفرضيات التي يجب التحقق من صحتها. والآن، حان وقت مواجهة واقع التجريب: لا يمكن اختبار كل شيء. نقص في الزيارات أو موارد التطوير أو التصميم أو التحليل، مقاومة من فرق أخرى، لا تنقص الأسباب لتأجيل اختبار. ومع ذلك، بالإضافة إلى كل هذه العقبات الحقيقية، يمكنكم تعقيد حياتكم أكثر بإضافة قيد إضافي، وهو إجراء اختبار واحد في كل مرة، باسم نقاء إحصائي مفترض يُحرج كتب المدارس، لكنه يُصفر وجه غالبية الممارسين.
مبدأ «اختبار واحد في كل مرة» المصمم أصلاً لحماية موثوقية النتائج، هو في الواقع العائق الرئيسي أمام سرعة منتجكم: أسابيع من الانتظار لكم ولفرقكم بينما ينافسكم المنافسون بالتقدم. لديكم، الابتكار ينتظر في الطابور.
ومع ذلك، فقد حل قادة القطاع هذه المشكلة منذ زمن طويل، ونهجهم أكثر سهولة مما نعتقد. أتظنون أن «المعتادين» على النمو الرقمي، مثل Google وMeta وNetflix وSpotify وBlaBlaCar وLeboncoin، يُشغّلون مئات بل آلاف الاختبارات في آن واحد باختبار واحد تلو الآخر؟ بالطبع لا. صحيح أن هذه الشركات العملاقة تمتلك إمكانيات استثنائية، لكن هذا ليس ما يفسر هذه الأعداد: عند مقارنة عدد الاختبارات بالفرق التي تديرها، ندرك أن الرافعة منهجية وليست ميزانية. خاصة وأن بعضها، مثل Google أو Netflix، يملك قوالب صفحات أقل من موقع تجارة إلكترونية. يجب أن تحمل كل صفحة بالضرورة عدة تجارب في آن واحد نظراً لأن Google Search لا يمكنه تحسين سوى صفحة نتائج البحث. قاعدة «واحد تلو الآخر» لم تعد ممارسة جيدة. إنها عائق تنافسي.
السؤال لم يعد ما إذا كان يجب تشغيل اختباراتكم بالتوازي. بل كيفية القيام بذلك دون المساس ببياناتكم أو منتجكم.
1. السرعة مقابل الخوف من التعارضات
واقع العمل
إذا كان الاختبار المعزول مرغوباً إحصائياً، فإنه مشلّ تشغيلياً. كل أسبوع يُقضى في انتظار انتهاء اختبار قبل إطلاق آخر هو أسبوع تعلم ضائع. على نطاق واسع، يُترجم ذلك إلى أشهر من القرارات المؤجلة والإيرادات الفائتة.
لنأخذ حالة ملموسة. فريق منتج لديه قائمة انتظار من 50 فرضية ودورة متوسطة مدتها ثلاثة أسابيع لكل اختبار لا يمكنه التحقق إلا من 17 فرضية سنوياً في النمط التسلسلي. الفريق نفسه، مع الضمانات المناسبة، يمكنه معالجة أربعة إلى خمسة أضعاف ذلك عبر الموازاة، أي كامل قائمة الانتظار وما ينتج عنها من تكرارات. الفارق ليس هامشياً: بناءً على معدل تعلم بنسبة 60% منه ثلث اختبارات رابحة، ستولّد الموازاة 30 درساً إضافياً، منها 10 اختبارات رابحة إضافية و20 خسارة تم تجنبها، مما يسمح بمضاعفة عائد الاستثمار لبرنامج التجريب أو حتى ثلاثة أضعافه.
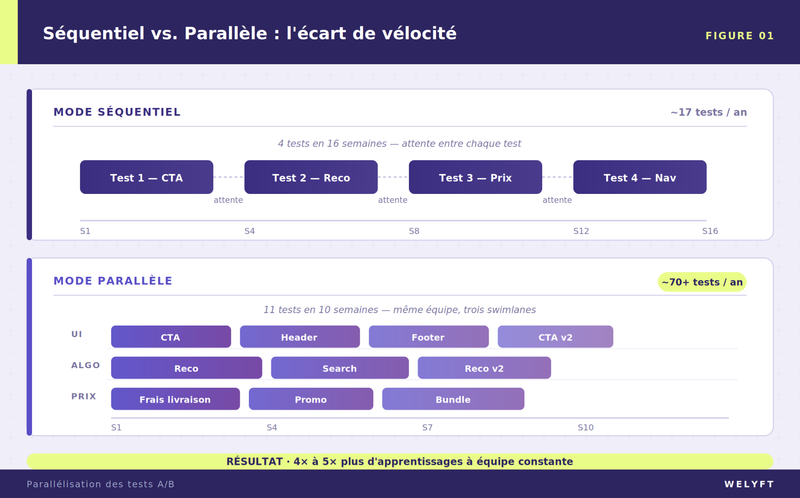
الشكل 1: نمذجة فروقات السرعة بين خارطة طريق تسلسلية وأخرى موازية
وهذا الفارق يتسع مع الوقت. الفرق التي تختبر أسرع تتعلم أسرع. والتي تتعلم أسرع تكرر أسرع. والتي تكرر أسرع تستحوذ على حصة غير متناسبة من القيمة في سوقها. هذا ليس نظرياً: إنه أثر مركب يُلاحظ لدى كل رائد رقمي جعل من الاختبار المتوازي ممارسة معيارية.
لماذا العزل؟ الخوف من آثار التفاعل
لنكن واضحين: آثار التفاعل موجودة فعلاً. إذا اختبرتم زراً أحمر وخلفية حمراء في آن واحد، فإنكم تخاطرون بجعل واجهتكم غير قابلة للقراءة لجزء من جمهوركم وإبطال كلا الاختبارين. هذا النوع من التعارض المباشر بين اختبارين، والذي يُسمى التفاعلات المتضاربة، قد يؤدي إلى تجارب مستخدم متدهورة وقرارات منتج مبنية على بيانات مشوهة.
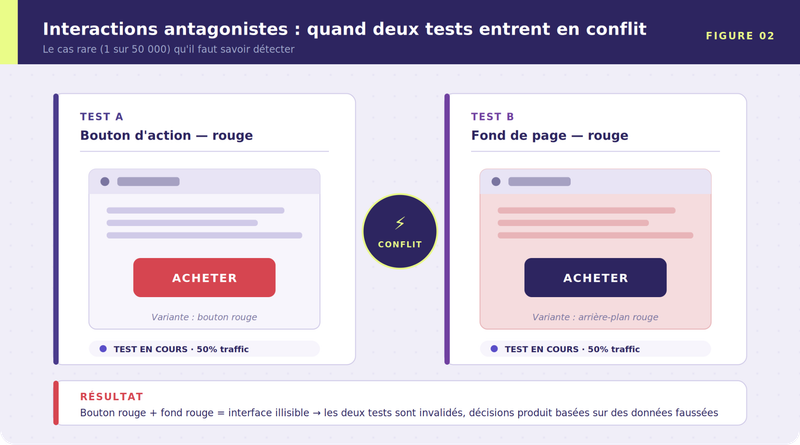
الشكل 2: توضيح للتفاعلات المتضاربة بين اختبارين متوازيين على نفس العنصر
لكن الواقع هو أن الغالبية الساحقة من التفاعلات بين الاختبارات غير موجودة، وعدد أقل منها ذو دلالة. أظهرت دراسة أجراها فريق التجريب في Microsoft (Kohavi et al.)، حللت مئات الآلاف من أزواج الاختبارات المتزامنة على Bing ومنتجات Microsoft، أن التفاعلات القوية بما يكفي لتحريف قرار الإطلاق لا تحدث إلا في حالة واحدة من أصل 50,000.
واحدة من أصل خمسين ألفاً.
تُفسَّر هذه الندرة ببساطة: من النادر أصلاً اكتشاف أثر ذي دلالة إحصائية عندما يعمل اختبار بمفرده (تشارك Spotify معدلات تعلم تبلغ 64%). لذا فمن النادر أكثر أن ينتج اختباران في آن واحد نتيجة ذات دلالة، ومن الأندر أن تقلب هذه الظاهرة قرار إطلاق. ومع ذلك، في الحالات النادرة التي توجد فيها تفاعلات قوية ولا تتم مراقبتها، يمكن أن ترتفع احتمالية اختيار النسخة الخاطئة إلى نحو ثلث الحالات.
الإجابة إذن ليست الثقة العمياء، بل وضع بنية وحوكمة تنظّمان هذه الموازاة من أجل رصد التفاعلات عند حدوثها والتعلّم منها.
2. كيف تُوازي الاختبارات كما تفعل أشهر برامج CRO؟
البنية الطبقية: خارطة طريق بممرات (swimlanes)
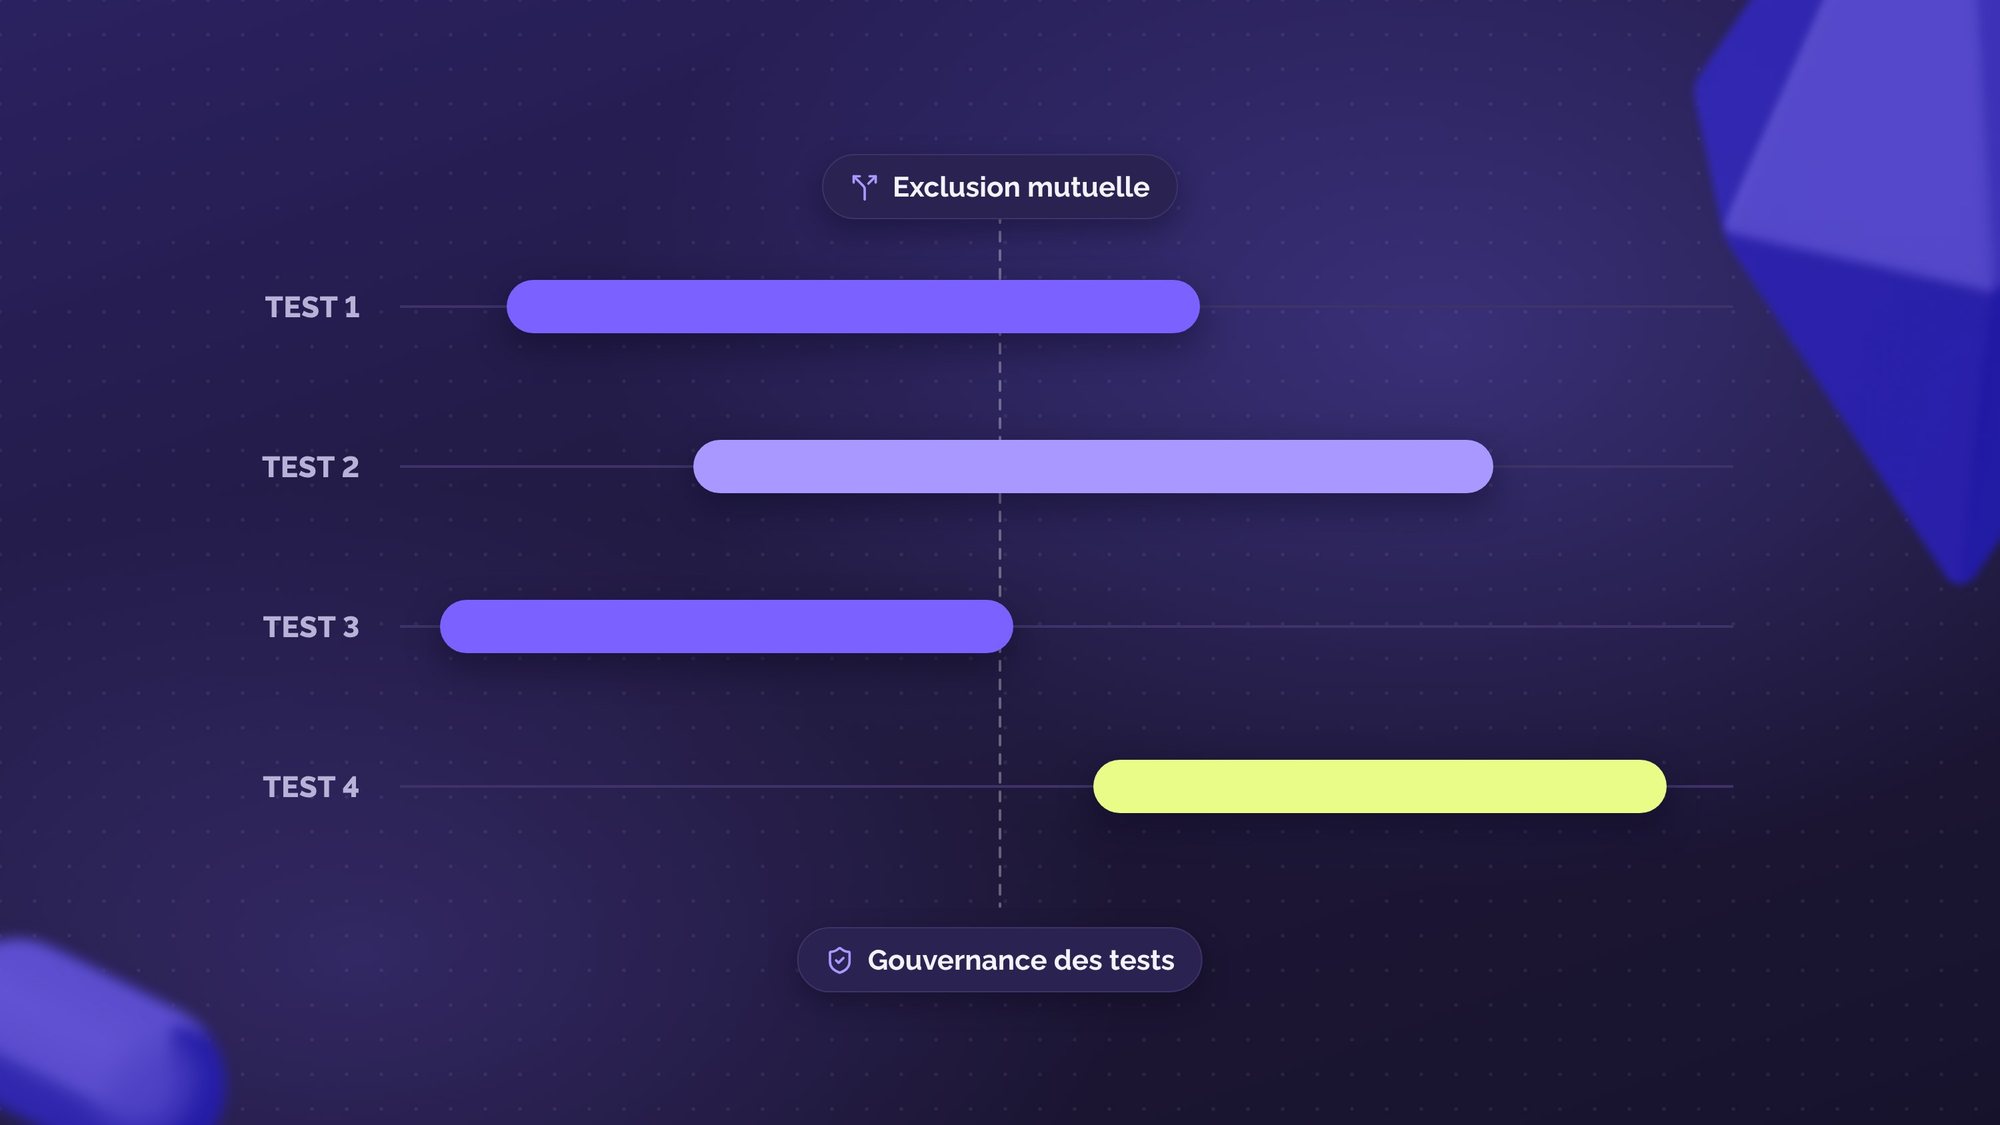
ردّ الفعل الأول لتحقيق الموازاة بأمان بسيط ولا يتطلب أي أداة متطورة: تقسيم اختباراتك يدويًا حسب النطاق والعنصر، تمامًا كما تنظّم خارطة طريق للمنتج بممرات (swimlanes). يمثّل كل ممر نطاقًا مستقلًا، ما يسمح بحد أدنى من التفاعل دون التضحية بالسرعة. وخلال رحلته، قد ينتقل المستخدم من ممر إلى آخر، وبالتالي من اختبار إلى آخر. وكما رأينا، هذا ليس مشكلة: المهم هو التأكد من عدم الوقوع في إحدى الحالات النادرة التي يشوّه فيها اختبار تفسير نتائج اختبار آخر.

الشكل 3: خارطة طريق بطبقات متمايزة بين الصفحات والعناصر لتأطير الموازاة
في Welyft، ننصح غالبًا بالبدء بنمذجة مستوى أول من الممرات يستند إلى قوالب الصفحات أو الشاشات، للتمييز بين مراحل الرحلة التي لكل منها تحديات خاصة بها. وإذا تطلّبت السرعة ذلك، يمكن بعد ذلك إضافة مستوى ثانٍ يستند إلى تقسيم أكثر مرونة: حسب العنصر، أو حسب نوع التغيير (واجهة المستخدم، خوارزمي، التسعير، إلخ)، أو حسب شريحة المستخدمين. وطالما أن تجربتين لا تمسّان النطاق نفسه، يمكنهما العمل بالتوازي دون خطر التداخل.
يصحّ هذا المنطق متى كانت اختباراتك تتناول عناصر متمايزة. أما إذا أردت، على العكس، قياس التفاعلات بين عدة عناصر في الصفحة نفسها، يمكنك اللجوء إلى اختبار متعدد المتغيرات (MVT). يكفي الإشارة إلى ذلك في خارطة طريقك بإدراج الاختبار نفسه في عدة ممرات في آن واحد.
على منصة تجارة إلكترونية، يعني هذا عمليًا: يمكن لمستخدم أن يشارك في آن واحد في اختبار حول صياغة مرحلة التوصيل، وفي اختبار حول محرك التوصيات، وفي MVT يقيس التفاعلات بين زر الإضافة إلى السلة، وموضع التقييمات، وتخطيط صور المنتج في صفحة المنتج، دون أي تصادم، لأن كل تجربة مخصّصة لممرها الخاص في خارطة الطريق.
يرتكز منطق الـ swimlanes على افتراض ضمني: ما تفعله مع مستخدم لا يؤثر على الآخرين. في سوق تعدّدي (VTC، توصيل الطعام، منصات الخدمات)، ينهار هذا الافتراض لأن العرض مشترك. فإذا زاد اختبار ما من الطلبات على جانب الطلب، فإن هذه الطلبات تستحوذ على مندوبي توصيل كان من الممكن أن يخدموا المجموعة الضابطة: تتفاعل المجموعتان وتبالغ النتيجة الملاحظة في تقدير الأثر الحقيقي. وهكذا تُضاف إلى التفاعلات بين الاختبارات فئة ثانية من التفاعلات، بين أنواع المستخدمين، لا تغطيها الـ swimlanes. وللتحكم فيها، يجب دمج تقنيات مخصّصة منذ إعداد خارطة الطريق، مثل العشوائية العنقودية (العزل حسب المنطقة الجغرافية) أو اختبار switchback (تبديل المعالجات عبر الزمن).
الأتمتة كشبكة أمان
هذا التنظيم اليدوي كافٍ للغالبية العظمى من البرامج. لكن عندما ينفجر حجم الاختبارات، يصبح الخطأ البشري التهديد الرئيسي، وهنا تتدخل الأتمتة.
يتمثّل المستوى الأول من الأتمتة، المتاح لجميع الفرق، في تشغيل فحوصات تلقائية على الاختبارات النشطة: تقيّم مهام يومية جميع أزواج الاختبارات الجارية وتُشير إلى التفاعلات الهامة. تُكتشف الحالة النادرة التي تحدث مرة واحدة من كل 50,000؛ وكل ما عدا ذلك يعمل بحرية. الموقف واضح: الموازاة افتراضيًا، والمراقبة المستمرة، والعزل فقط عندما تقتضي البيانات ذلك.
بالنسبة للبرامج ذات الحجم الكبير جدًا، يمكن اعتماد مستوى ثانٍ: إضفاء الطابع الرسمي على بنية خارطة الطريق نفسها بآليات تقنية (hash-salts مختلفة لكل طبقة، تعيين مستقل للمستخدمين)، ما يضمن العزل بالتصميم. لكن بالنسبة للغالبية العظمى من الفرق، لا يُبرَّر هذا المستوى من الاستثمار؛ فتنظيم خارطة الطريق جيدًا بممرات (swimlanes) يكفي لتحصيل معظم مكاسب السرعة.
3. لماذا لا تكفي التقنية؟
كل ما استعرضناه للتو، الـ swimlanes، الـ MVT، الأتمتة، متاح تقنيًا. ومع ذلك، قلة قليلة من المؤسسات تنجح فعليًا في تحقيق ذلك. لماذا؟ لأن العائق الحقيقي ليس أبدًا الأداة، بل كل ما يجب أن يوجد حولها.
المشكلة الحقيقية تنظيمية
عندما يمكن لعدة فرق إطلاق اختبارات بالتوازي، يجب أن يمتلك أحدهم قواعد اللعبة. من يمكنه اختبار ماذا، وعلى أي طبقة؟ ما الذي يشكّل مؤشر أداء رئيسيًا صالحًا؟ متى يكون الاختبار ناضجًا بما يكفي لاختتامه؟ من يحسم الأمر عندما يستهدف اختباران الشريحة نفسها؟ الأتمتة تطبّق القواعد، لا تكتبها. فبدون حوكمة واضحة، تخلق الموازاة ارتباكًا لا قيمة.
الثقة كمحرك للتغيير
وحتى مع قواعد واضحة، تبقى عقبة أكثر خفاءً: جعل هذه القواعد مقبولة. فصنّاع القرار الكبار الذين بنوا حدسهم على نتائج معزولة، كثيرًا ما يرفضون الاستنتاجات المستخلصة من اختبارات مُوازية، خصوصًا الاستنتاجات غير المواتية، بدافع رد الفعل لا التحليل. وتصبح عبارة «هذه النتائج غير موثوقة، كانت هناك اختبارات أخرى جارية» حجة مريحة لتجاهل بيانات مزعجة.
هذا بالضبط ما يجب أن تحققه الحوكمة: بناء الثقة المؤسسية في الإطار المنهجي لا يقل أهمية عن بناء الإطار نفسه. ويتحقق ذلك من خلال التوعية، والنتائج القابلة للتكرار، والشفافية الكاملة حول المنهجية؛ لا من خلال عرض تقديمي إضافي في اجتماع لجنة الإدارة.
أهمية وجود خبرة متخصصة
امتلاك الحوكمة وبناء هذه الثقة مهنة قائمة بذاتها. المؤسسات التي توسّع برامج تجاربها المتوازية تشترك جميعها في سمة واحدة: وجود وظيفة مخصصة تمتلك المنهجية، وقواعد الحوكمة، ورفع كفاءة الفرق. في Google أو Netflix، يوجد جيش من المتخصصين الداخليين، وهو ترف غير واقعي وغير منطقي اقتصاديًا بالنسبة لمعظم الشركات الفرنسية والأوروبية.
تعمل Welyft على هيكلة وتسريع برامج عملائها لتحقيق أقصى قدر من التعلّم، دون المساس أبدًا بموثوقية النتائج، بدءًا من بنية الاختبارات مرورًا بحوكمة البرنامج وصولًا إلى تدريب صنّاع القرار.
انتقل إلى العمل
موازاة اختبارات A/B ليست مغامرة متهورة مقتصرة على عمالقة التقنية الذين يملكون ملايين المستخدمين يوميًا. إنها المعيار التشغيلي لأي فريق رقمي جاد في مسار نموه.
التحدي الحقيقي ليس إحصائيًا؛ فدراسة Microsoft وممارسات كبار المجرّبين تثبت ذلك. إنه تحدٍ تنظيمي. الفرق التي تحدّ من نفسها خوفًا من التفاعلات لا تفشل لأن هذه المخاوف تحققت. بل تفشل لأن لا أحد امتلك الحوكمة ولا أحد بنى الثقة اللازمة للتصرف بناءً على نتائج لا «تبدو» نظيفة.
هذا بالضبط نوع التحدي الإحصائي والتقني والتنظيمي الذي ترافق فيه Welyft الفرق الرقمية الفرنسية والأوروبية يوميًا. من بنية التجارب إلى حوكمة البرامج، مرورًا بتدريب صنّاع القرار، صُمم نهجنا ليتناسب مع واقع سوقكم، بما في ذلك متطلبات RGPD.
هل تريد التعمق أكثر قبل الانطلاق؟ لقد أعددنا مراجعة شاملة للأطر الإحصائية والبنى وممارسات أفضل فرق التجريب في العالم، دليل عملي لهيكلة مسارك الخاص.