
分析とアイデア出しの作業はしっかり行いました。顧客と話し、データを精査し、さまざまな部門とインサイトを共有しました。つまり、最適化すべき導線や、テストすべき機能など、検証すべき仮説を何十、何百と洗い出したのです。しかし今度は、実験の現実に直面しなければなりません。すべてをテストすることはできないのです。トラフィック不足、開発・デザイン・分析リソースの不足、他部門からの抵抗など、テストを先送りにする理由には事欠きません。それでも、こうした現実的な障害に加えて、さらに自ら制約を増やし、教科書なら赤面するほど厳密な統計的純粋性を理由に「一度に一つのテストしか行わない」というルールを課すこともできてしまいます。しかし、それは実務家の多くを青ざめさせるものです。
本来、結果の信頼性を守るために考案された「一度に一つのテスト」という原則は、実際にはプロダクトのベロシティにとって最大の足かせとなっています。あなたとあなたのチームが何週間も待たされている間に、競合は先へ進んでいくのです。あなたの会社では、イノベーションが順番待ちをしているのです。
しかし、業界のリーダーたちはこの問題をとうの昔に解決しており、そのアプローチは思われているよりもずっと手の届くものです。デジタル成長の「常連」であるGoogle、Meta、Netflix、Spotify、BlaBlaCar、Leboncoinが、数百、時には数千ものテストを一つずつ順番に回していると思いますか?もちろん違います。確かにこれらの巨大企業は桁外れのリソースを持っていますが、それだけではこの数は説明できません。テスト数をそれを運用するチームの規模で割ってみると、鍵となっているのは予算ではなく方法論であることが分かります。しかも、GoogleやNetflixなどは、ECサイトよりもページテンプレートの数が少ないのです。Google検索では検索結果ページしか最適化できないため、各ページは必然的に複数の実験を同時に抱えることになります。「一度に一つ」というルールはもはやベストプラクティスではありません。それは競争上のハンディキャップなのです。
問題はもはや、テストを並列で実施すべきかどうかではありません。データやプロダクトを損なうことなく、どうやってそれを実現するかなのです。
1. ベロシティ vs. 衝突への恐れ
ビジネスの現実
単独のテストは統計的には望ましいものの、運用面では停滞を招きます。あるテストの終了を待ってから次を始めるまでの1週間1週間が、失われた学習の機会となります。規模が大きくなれば、それは何カ月分もの意思決定の遅れと逸失収益に換算されます。
具体例を見てみましょう。50件の仮説のバックログを持ち、1テストあたり平均3週間のサイクルを要するプロダクトチームは、逐次的に進めると年間17件の仮説しか検証できません。同じチームが適切なガードレールを設けて並列化すれば、4〜5倍の仮説を処理でき、バックログ全体とそこから派生するイテレーションをすべてこなすことができます。この差は決して小さくありません。学習率60%、そのうち3分の1が勝利テストという前提で試算すると、並列化によって30件の追加学習、うち10件の追加勝利テストと20件の損失回避が生まれ、実験プログラムのROIを2倍、場合によっては3倍にすることができます。
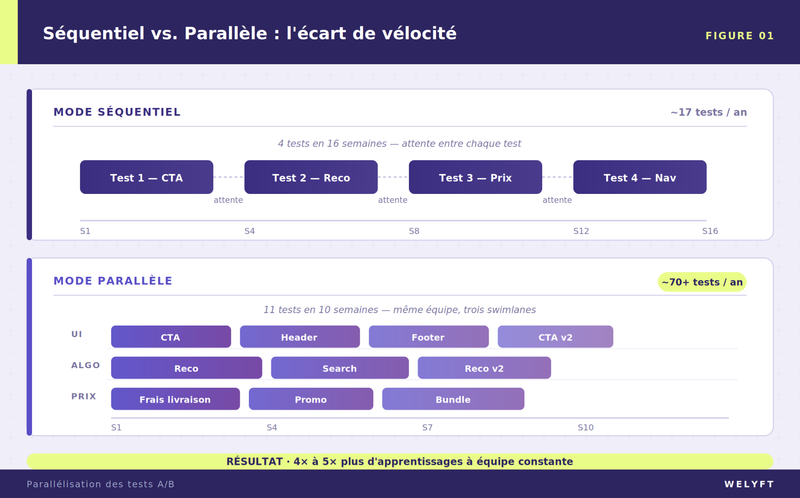
図1:逐次ロードマップと並列化ロードマップにおけるベロシティの差のモデル化
そしてこの差は時間とともに広がっていきます。より速くテストするチームはより速く学びます。より速く学ぶチームはより速くイテレーションを回します。そしてより速くイテレーションを回すチームは、市場の価値のうち不釣り合いに大きな部分を獲得します。これは理論上の話ではありません。並列テストを標準的な実践としているすべてのデジタルリーダーにおいて観測される複利効果なのです。
なぜ分離するのか?相互作用効果への恐れ
はっきりさせておきましょう。相互作用効果は確かに存在します。赤いボタンと赤い背景を同時にテストすれば、一部のオーディエンスにとってインターフェースが読みにくくなり、両方のテストを無効にしてしまう恐れがあります。このような2つのテスト間の直接的な衝突は「拮抗的相互作用」と呼ばれ、ユーザー体験の劣化や、誤ったデータに基づくプロダクト判断につながる可能性があります。
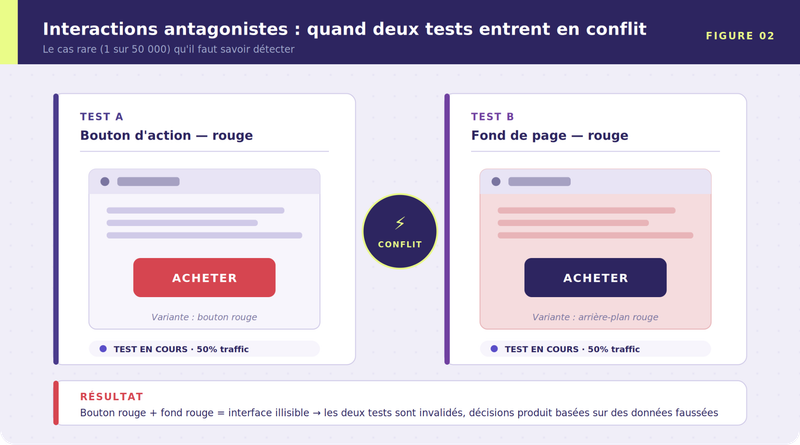
図2:同一要素に対して並列化された2つのテスト間の拮抗的相互作用の例
しかし現実には、テスト間の相互作用は圧倒的多数が存在せず、有意なものはさらに少数です。Microsoftの実験チーム(Kohavi氏ら)が、BingおよびMicrosoft製品における数十万件の同時テストペアを分析した研究によると、本番展開の判断を誤らせるほど重大な相互作用が発生するのは5万件に1件のみであることが示されています。
5万分の1です。
この希少性は単純に説明がつきます。そもそも単独で動かしているテストで統計的に有意な効果を検出すること自体が稀なのです(Spotifyは学習率64%を公表しています)。したがって、2つのテストが同時に有意な結果を出すことはさらに稀であり、その現象が本番展開の判断を覆すことはなおさら稀です。とはいえ、強い相互作用が存在し、かつ監視されていない希少なケースでは、誤ったバリアントを選んでしまう確率がおよそ3分の1にまで跳ね上がることがあります。
答えは盲目的な信頼ではありません。インタラクションが発生した際にそれを検知し、そこから学ぶための、並列化を統括するアーキテクチャとガバナンスを構築することが重要なのです。
2. 最も評価の高いCROプログラムのように並列化するには?
レイヤー構造のアーキテクチャ:スイムレーンを用いたロードマップ
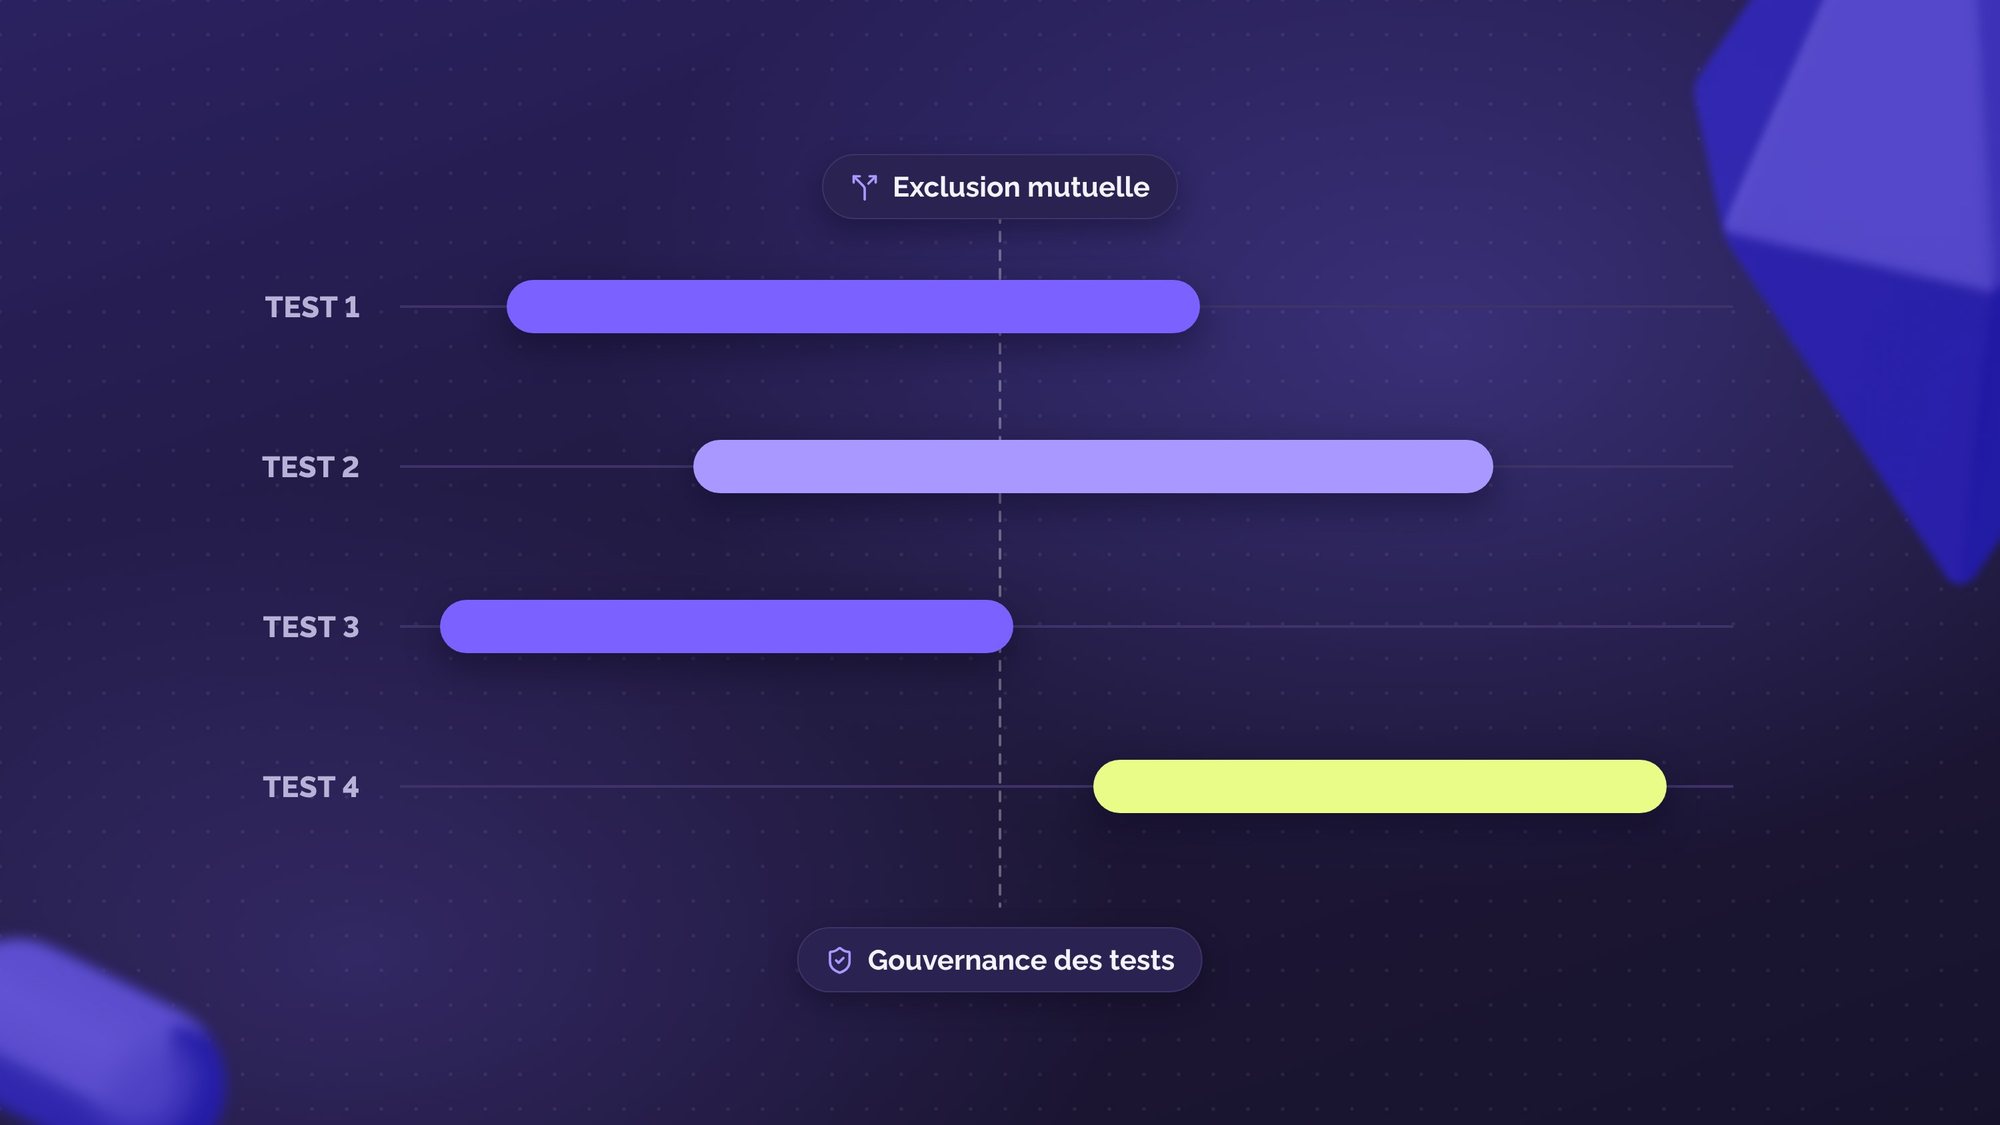
安全に並列化するための最初のステップはシンプルで、高度なツールを必要としません。テストを対象範囲や要素ごとに手動で分けること、つまり、プロダクトロードマップをスイムレーンで整理するのと同じ考え方です。各レーンは独立した対象範囲を表し、速度を犠牲にすることなく最小限のインタラクションを許容します。ユーザーは利用の過程で、あるレーンから別のレーンへ、つまり一つのテストから別のテストへと移ることがあります。そして、これまで見てきたように、それ自体は問題ではありません。重要なのは、一方のテストがもう一方の結果の解釈を歪めてしまう、稀なケースに陥らないよう確認することです。

図3:ページや要素ごとに明確なレイヤーを設けて並列化の枠組みを定めたロードマップ
Welyftでは、まずページやスクリーンのテンプレートに基づいた第一階層のレーンをモデル化することから始めることを推奨しています。これにより、それぞれ固有の課題を持つ利用プロセスの各段階を区別できます。速度の必要に応じて、要素ごと、変更の種類ごと(UI、アルゴリズム、価格設定など)、あるいはユーザーセグメントごとといった、より自由な切り口に基づく第二階層を追加することも可能です。2つの実験が同じ対象範囲に触れない限り、干渉のリスクなく並行して実行できます。
このロジックは、テストが異なる要素を対象としている限り機能します。逆に、同一ページ内の複数要素間のインタラクションを測定したい場合は、多変量テスト(MVT)を利用できます。その場合は、同じテストを複数のレーンに同時に記載することで、ロードマップ上に明示すれば十分です。
Eコマースプラットフォームを例にすると、具体的には次のようになります。あるユーザーが、配送ステップの文言に関するテスト、レコメンドエンジンに関するテスト、そしてカート追加のCTA・レビューの表示位置・商品ページの画像レイアウトの間のインタラクションを測定するMVTに同時に参加しても、何の衝突も起こりません。なぜなら、それぞれの実験がロードマップ上で独自のレーンに割り当てられているからです。
スイムレーンのロジックは、「あるユーザーに対して行うことが他のユーザーに影響を与えない」という暗黙の前提に基づいています。マーケットプレイス(配車サービス、料理宅配、サービスプラットフォームなど)では、供給が共有されているため、この前提が成り立ちません。あるテストが需要側の注文を増加させると、その注文が、本来コントロールグループに割り当てられるはずだった配達員を奪ってしまいます。つまり両グループが相互作用し、観測される結果は実際の効果を過大評価してしまうのです。このように、テスト間のインタラクションに加えて、スイムレーンではカバーできないユーザータイプ間のインタラクションという第二のカテゴリーが存在します。これを管理するには、ロードマップの段階から、クラスター単位のランダム化(地理的エリアごとの分離)やスイッチバックテスト(時間軸での処理の切り替え)といった専用の手法を組み込む必要があります。
セーフティネットとしての自動化
この手動での運用方法は、大多数のプログラムにとって十分な対応です。しかし、テストの数が爆発的に増加すると、ヒューマンエラーが最大のリスクとなり、そこで自動化の出番となります。
すべてのチームが導入できる最初のレベルの自動化は、稼働中のテストに対して自動検証を実行することです。日次ジョブが、実行中のすべてのテストのペアを評価し、有意なインタラクションを検知します。5万分の1という稀なケースも検知され、それ以外はすべて自由に実行されます。方針は明確です。デフォルトでは並列化し、継続的に監視し、データが必要とする場合にのみ分離するということです。
非常に多くのテストを扱うプログラムでは、さらに一段階先に進むことも可能です。ロードマップそのものの構造を技術的な仕組み(レイヤーごとに異なるハッシュソルト、ユーザーの独立した割り当てなど)で形式化し、構造的に分離を保証するのです。ただし、大多数のチームにとっては、この水準の投資は正当化されず、ロードマップをスイムレーンで適切に整理するだけで、速度向上のメリットの大部分を得ることができます。
3. なぜ技術だけでは不十分なのか?
ここまで見てきたスイムレーン、MVT、自動化は、いずれも技術的には実現可能です。それにもかかわらず、実際にこれを成し遂げている組織はごくわずかです。なぜでしょうか。本当のボトルネックは決してツールではなく、その周囲に整備されるべきすべてのものにあるからです。
本当の問題は組織にある
複数のチームが並行してテストを開始できる場合、誰かがそのルールを所有していなければなりません。誰が、どのレイヤーで、何をテストできるのか。何が有効なKPIと見なされるのか。テストはいつ十分に成熟したと判断され、終了できるのか。2つのテストが同じセグメントを対象とする場合、誰が調整するのか。自動化はルールを適用するものであり、ルールを作るものではありません。明確なガバナンスがなければ、並列化は価値ではなく混乱を生み出します。
変化を推進するものとしての信頼
そして、たとえ明確なルールがあったとしても、より厄介な障害が残ります。それは、そのルールを受け入れてもらうことです。個々の結果を基に自らの勘を築き上げてきたシニアの意思決定者たちは、並列化されたテストから得られた結論、特に望ましくない結論を、分析ではなく反射的な拒否反応で却下することが少なくありません。「この結果は信頼できない、他のテストが同時に動いていたから」という言葉は、都合の悪いデータを無視するための便利な口実になってしまうのです。
これこそまさにガバナンスが生み出すべきものです。方法論の枠組みにおいて組織的な信頼を構築することは、その枠組み自体を構築することと同じくらい重要です。これには、教育的な説明、再現可能な結果、そして方法論に関する完全な透明性が必要です。経営会議でのさらなるスライドデッキでは実現できません。
専門的な知見の重要性
ガバナンスを所有し、この信頼を築くことは、それ自体が一つの専門職です。並行実験プログラムをスケールさせている組織には共通点があります。方法論、ガバナンスルール、そしてチームのスキルアップを担う専任機能を持っていることです。GoogleやNetflixでは、社内スペシャリストの大軍が存在しますが、これはフランスやヨーロッパのほとんどの企業にとって現実的でも経済的に合理的でもない贅沢です。
Welyftは、クライアントのプログラムを構造化し加速させることで、結果の信頼性を一切損なうことなく、最大限の学びを提供します。テストアーキテクチャからプログラムガバナンス、意思決定者のトレーニングに至るまで対応します。
行動を起こしましょう
A/B tests を並行して実施することは、1日あたり数百万人のユーザーを抱えるテック業界の巨人だけに許された無謀な賭けではありません。成長戦略に真剣に取り組むあらゆるデジタルチームにとっての業務標準です。
真の課題は統計的なものではありません。Microsoftの調査結果や最大手の実験者たちの実践がそれを証明しています。課題は組織的なものです。相互作用への懸念から自らを制限するチームは、その懸念が現実になったから失敗するのではありません。誰もガバナンスを所有しておらず、「きれいに見えない」結果に基づいて行動するために必要な信頼を誰も築いていなかったから失敗するのです。
まさにこのような統計的、技術的、組織的な課題にこそ、Welyftはフランスおよびヨーロッパのデジタルチームの日々の実務に寄り添って対応しています。実験アーキテクチャからプログラムガバナンス、意思決定者のトレーニングに至るまで、私たちのアプローチはRGPDを含む貴社の市場の実情に合わせて設計されています。
踏み出す前にさらに深く知りたいですか?私たちは、世界最高の実験チームが採用する統計的フレームワーク、アーキテクチャ、実践方法に関する包括的なレビューをまとめました。これは、あなた自身の取り組みを構築するための実践的なガイドです。