
Avete svolto bene il vostro lavoro di analisi e ideazione: avete parlato con i vostri clienti, scomposto i vostri dati, confrontato con diversi reparti per ottenere i loro insight. In breve, avete identificato una serie di percorsi da ottimizzare, di funzionalità da testare, insomma decine e decine di ipotesi da validare. Ora bisogna confrontarsi con la realtà della sperimentazione: non tutto può essere testato. Mancanza di traffico, di risorse di sviluppo, di design o di analisi, resistenza di altri team, le ragioni per rimandare un test non mancano. Eppure, oltre a tutti questi ostacoli ben reali, potreste complicarvi ulteriormente la vita aggiungendo un vincolo in più, fare un solo test alla volta, in nome di una presunta purezza statistica che farebbe arrossire un manuale scolastico, ma impallidire la maggior parte dei professionisti.
Questo principio del «un test alla volta», concepito originariamente per proteggere l'affidabilità dei risultati, è in realtà il principale freno alla vostra velocità di prodotto: settimane di attesa per voi e i vostri team mentre i vostri concorrenti avanzano. Da voi, l'innovazione fa la fila.
Eppure, i leader del settore hanno risolto questo problema da tempo e il loro approccio è più accessibile di quanto si pensi. Credete che i «soliti sospetti» della crescita digitale, Google, Meta, Netflix, Spotify, BlaBlaCar, Leboncoin, facciano girare centinaia, a volte migliaia di test simultaneamente procedendo uno alla volta? Certo che no. Certo, questi giganti dispongono di mezzi fuori dal comune, ma non è questo a spiegare questi volumi: quando si rapporta questo numero di test ai team che li gestiscono, ci si rende conto che la leva è metodologica, non di budget. Tanto più che alcuni di loro, Google o Netflix ad esempio, dispongono di meno template di pagina di un sito e-commerce. Ogni pagina deve necessariamente portare più esperimenti contemporaneamente poiché Google Search può ottimizzare solo la pagina dei risultati di ricerca. La regola del «uno alla volta» non è più una buona pratica. È uno svantaggio competitivo.
La domanda non è più se far girare i vostri test in parallelo. È sapere come farlo senza compromettere i vostri dati né il vostro prodotto.
1. Velocità vs. Paura delle collisioni
La realtà del business
Se un test isolato è statisticamente auspicabile, è operativamente paralizzante. Ogni settimana trascorsa ad attendere la fine di un test prima di lanciarne un altro è una settimana di apprendimento perduta. Su larga scala, questo si traduce in mesi di decisioni ritardate e ricavi mancati.
Prendiamo un caso concreto. Un team di prodotto con un backlog di 50 ipotesi e un ciclo medio di tre settimane per test può validare solo 17 ipotesi all'anno in modalità sequenziale. Lo stesso team, con le giuste salvaguardie, può gestirne da quattro a cinque volte di più parallelizzando, ovvero l'intero backlog e le iterazioni che ne derivano. Il divario non è marginale: estrapolando da un tasso di apprendimento del 60%, di cui un terzo di test vincenti, la parallelizzazione genererebbe 30 insegnamenti aggiuntivi, di cui 10 test vincenti supplementari e 20 perdite evitate, permettendo di raddoppiare o addirittura triplicare il ROI di un programma di sperimentazione.
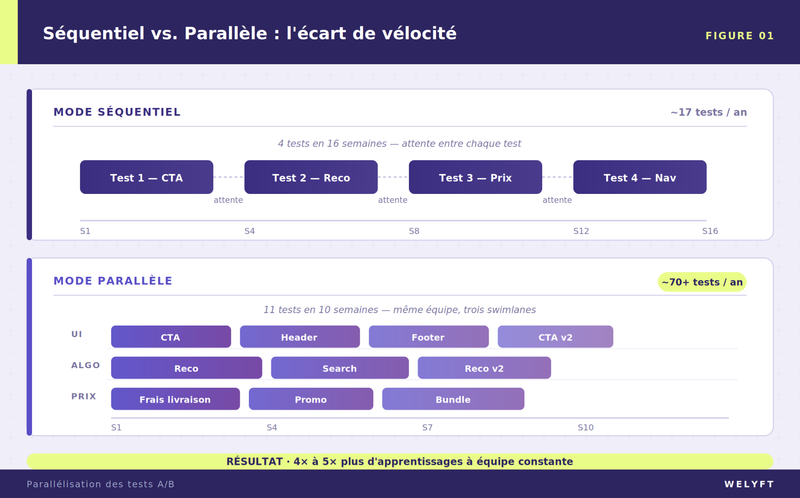
Figura 1: modellazione degli scarti di velocità tra una roadmap sequenziale e una parallelizzata
E questo scarto si amplifica con il tempo. I team che testano più velocemente imparano più velocemente. Quelli che imparano più velocemente iterano più velocemente. E quelli che iterano più velocemente catturano una quota sproporzionata di valore sul loro mercato. Non è teorico: è un effetto composto che si osserva in ogni leader digitale che ha fatto del testing parallelo una pratica standard.
Perché isolare? La paura degli effetti di interazione
Siamo chiari: gli effetti di interazione esistono. Se testate un pulsante rosso e uno sfondo rosso contemporaneamente, rischiate di rendere la vostra interfaccia illeggibile per una parte del vostro pubblico e di invalidare entrambi i test. Questo tipo di conflitto diretto tra due test, che viene chiamato interazioni antagoniste, può portare a esperienze utente degradate e a decisioni di prodotto basate su dati falsati.
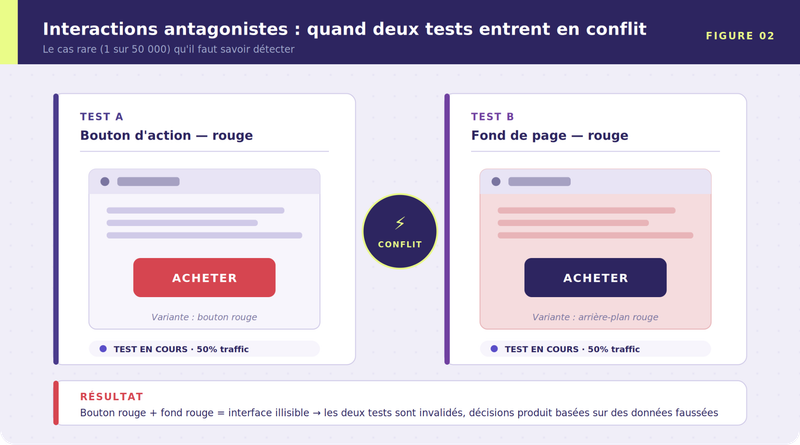
Figura 2: illustrazione di interazioni antagoniste tra due test parallelizzati su uno stesso elemento
Ma la realtà è che la stragrande maggioranza delle interazioni tra test sono inesistenti e ancora meno sono significative. Uno studio condotto dal team di sperimentazione di Microsoft (Kohavi et al.), che ha analizzato centinaia di migliaia di coppie di test simultanei su Bing e sui prodotti Microsoft, ha dimostrato che le interazioni sufficientemente importanti da falsare una decisione di messa in produzione si verificano solo in 1 caso su 50.000.
Uno su cinquantamila.
Questa rarità si spiega semplicemente: è già raro rilevare un effetto statisticamente significativo quando un test gira da solo (Spotify condivide tassi di apprendimento del 64%). È quindi ancora meno frequente che due test producano simultaneamente un risultato significativo ed è ancora più raro che questo fenomeno inverta una decisione di messa in produzione. Detto questo, nei rari casi in cui esistono interazioni forti e non vengono monitorate, la probabilità di scegliere la variante sbagliata può salire fino a circa un terzo dei casi.
La risposta non è quindi la fiducia cieca. È la messa in atto di un'architettura e di una governance che orchestrano questa parallelizzazione al fine di rilevare le interazioni quando ce ne sono e di imparare da esse.
2. Come parallelizzare come i programmi CRO più rinomati?
L'architettura a livelli: una roadmap con swimlane
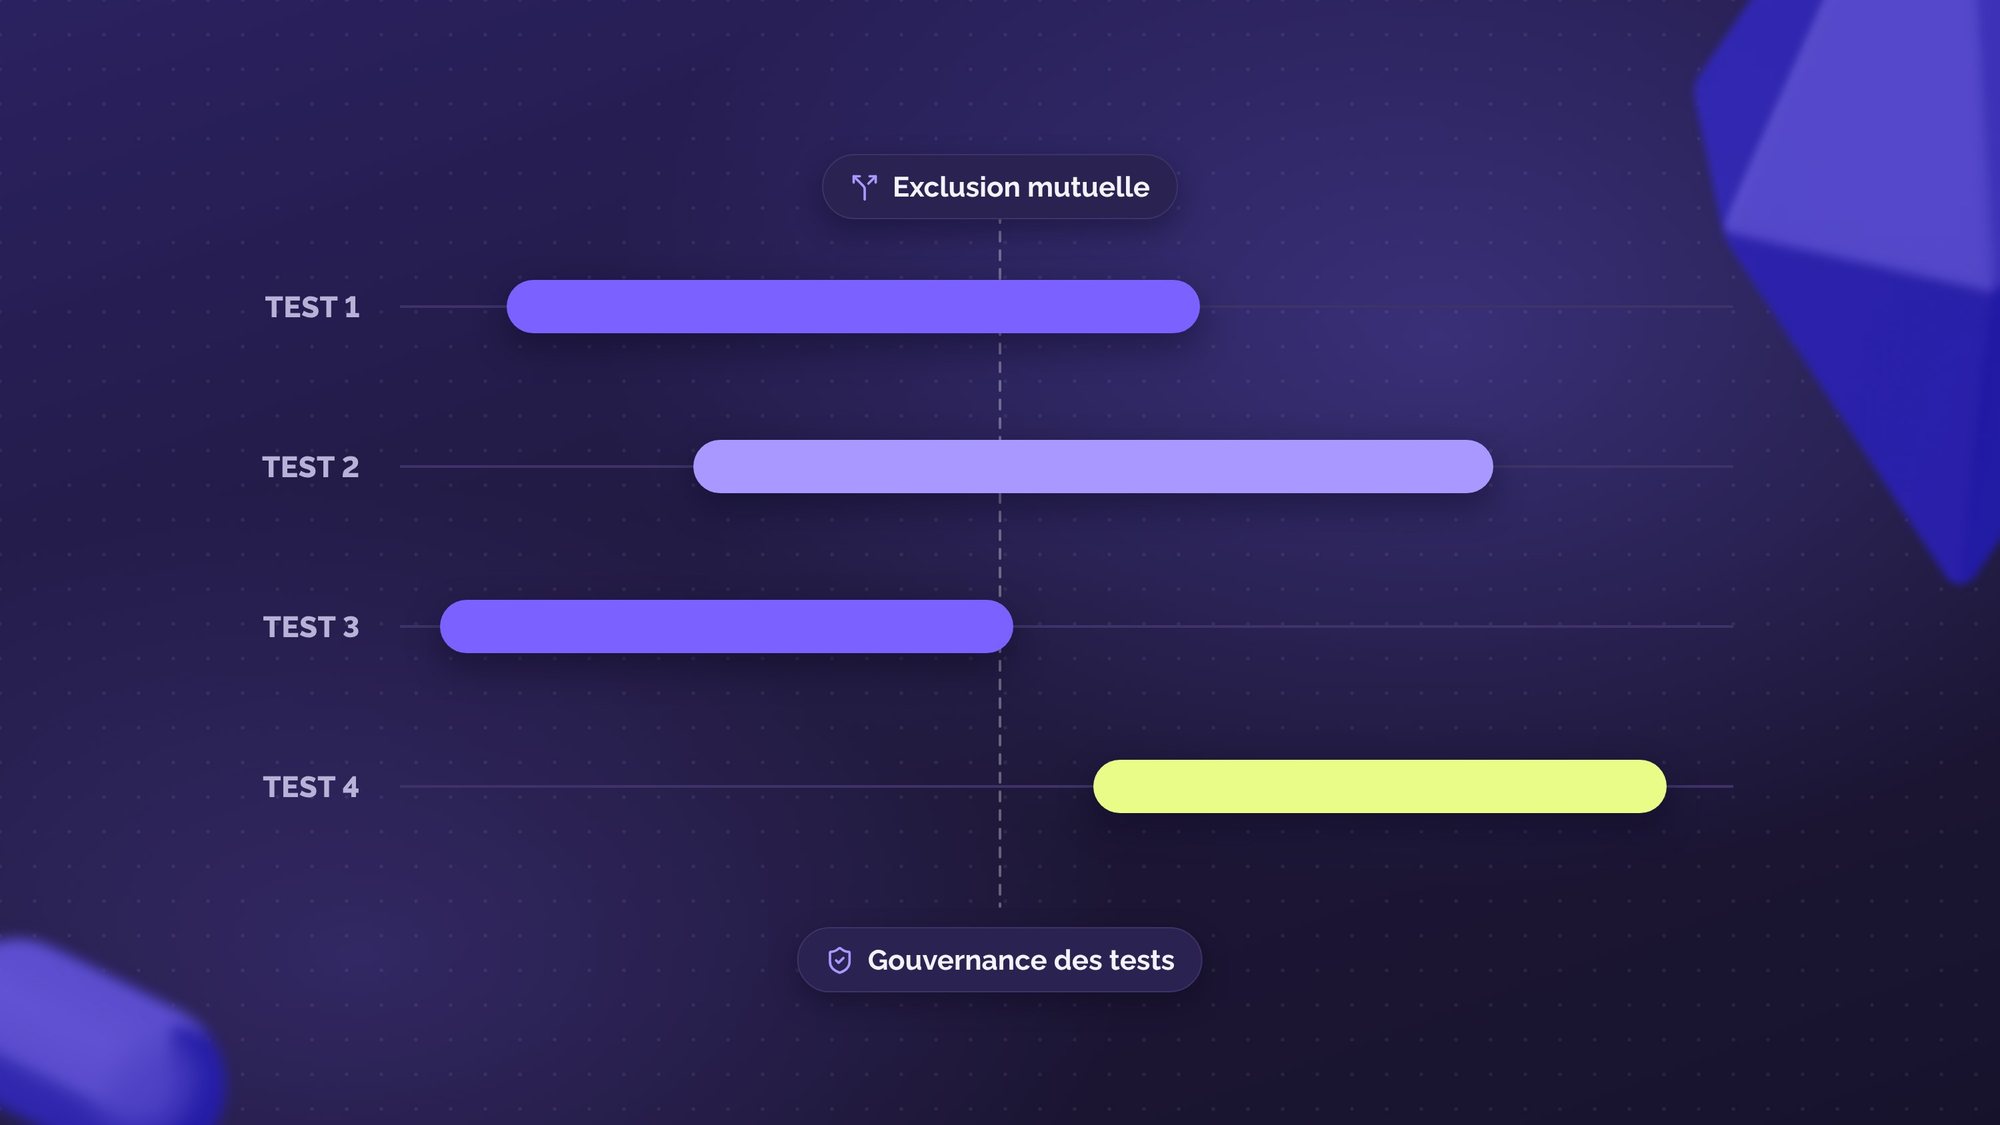
Il primo riflesso per parallelizzare in totale sicurezza è semplice e non richiede alcuno strumento sofisticato: separare manualmente i test per perimetro e per elemento, esattamente come si organizzerebbe una roadmap di prodotto con swimlane. Ogni corsia rappresenta un perimetro distinto, consentendo un minimo di interazione senza sacrificare la velocità. Nel corso del suo percorso, un utente potrà passare da una corsia all'altra e quindi da un test all'altro. E come abbiamo visto, non è un problema: l'importante è assicurarsi di non cadere in uno dei rari casi in cui un test falsa l'interpretazione dei risultati dell'altro.

Figura 3: Una roadmap con livelli distinti tra le pagine e gli elementi per inquadrare la parallelizzazione
Da Welyft, si consiglia spesso di iniziare modellando un primo livello di corsia basato sui template di pagine o schermate, per distinguere le tappe del percorso che hanno ciascuna problematiche proprie. Se la velocità lo richiede, si può poi aggiungere un secondo livello basato su una suddivisione più libera: per elemento, per tipo di cambiamento (UI, algoritmico, pricing, ecc.), o per segmento di utente. Finché due sperimentazioni non toccano lo stesso perimetro, possono girare in parallelo senza rischio di interferenza.
Questa logica funziona quando i test riguardano elementi distinti. Se invece si desidera misurare le interazioni tra più elementi di una stessa pagina, si può ricorrere a un test multivariato (MVT). Basta segnalarlo nella roadmap facendo figurare lo stesso test su più corsie simultaneamente.
Su una piattaforma e-commerce, questo si traduce concretamente così: un utente può partecipare simultaneamente a un test sul wording della fase di consegna, a un test sul motore di raccomandazione e a un MVT che misura le interazioni tra il CTA di aggiunta al carrello, la posizione delle recensioni e il layout delle immagini prodotto sulla pagina prodotto senza alcuna collisione, perché ogni sperimentazione è assegnata alla propria corsia nella roadmap.
La logica delle swimlane si basa su un'ipotesi implicita: ciò che si fa con un utente non influisce sugli altri. In una marketplace (VTC, consegna pasti, piattaforme di servizi), questa ipotesi crolla, perché l'offerta è condivisa. Se un test aumenta gli ordini lato domanda, questi ordini accaparrano fattorini che avrebbero servito il gruppo di controllo: i due gruppi interagiscono e il risultato osservato sovrastima l'effetto reale. Alle interazioni tra test si aggiunge quindi una seconda famiglia di interazioni, tra tipi di utenti, che le swimlane non coprono. Per padroneggiarla, è necessario integrare fin dalla roadmap tecniche dedicate come la randomizzazione per cluster (isolare per zona geografica) o lo switchback testing (alternare i trattamenti nel tempo).
L'automazione come rete di sicurezza
Questa organizzazione manuale è sufficiente per la grande maggioranza dei programmi. Ma quando il volume di test esplode, l'errore umano diventa la minaccia principale ed è lì che interviene l'automazione.
Il primo livello di automazione, accessibile a tutti i team, consiste nel far girare verifiche automatiche sui test attivi: job quotidiani valutano tutte le coppie di test in corso e segnalano le interazioni significative. Il caso raro dell'1 su 50.000 viene rilevato; tutto il resto gira liberamente. La postura è chiara: parallelizzare di default, monitorare in continuo, isolare solo quando i dati lo richiedono.
Per i programmi ad altissimo volume, è possibile un secondo livello: formalizzare l'architettura stessa della roadmap con meccanismi tecnici (hash-salt distinti per livello, assegnazione indipendente degli utenti) il che garantisce l'isolamento per costruzione. Ma per la grande maggioranza dei team questo livello di investimento non è giustificato: organizzare bene la propria roadmap in swimlane è sufficiente per recuperare l'essenziale dei guadagni di velocità.
3. Perché la tecnica non basta?
Tutto ciò che abbiamo appena visto, swimlane, MVT, automazione, è tecnicamente accessibile. Eppure, pochissime organizzazioni ci riescono realmente. Perché? Perché il vero collo di bottiglia non è mai lo strumento. È tutto ciò che deve esistere intorno.
Il vero problema è organizzativo
Quando più team possono lanciare test in parallelo, bisogna che qualcuno possieda le regole del gioco. Chi può testare cosa, su quale livello? Cosa costituisce un KPI valido? Quando un test è sufficientemente maturo per essere concluso? Chi arbitra quando due test puntano allo stesso segmento? L'automazione applica regole, non le scrive. Senza una governance chiara, la parallelizzazione crea confusione, non valore.
La fiducia come motore del cambiamento
E anche con regole chiare, resta un ostacolo più insidioso: far accettare queste regole. I decision maker senior che hanno costruito il proprio istinto su risultati isolati spesso rifiuteranno le conclusioni derivanti da test parallelizzati, soprattutto le conclusioni sfavorevoli, per riflesso piuttosto che per analisi. «Questi risultati non sono affidabili, c'erano altri test in corso» diventa un argomento comodo per ignorare dati scomodi.
È esattamente questo che la governance deve produrre: costruire la fiducia istituzionale nel quadro metodologico è importante quanto costruire il quadro stesso. Ciò passa attraverso la pedagogia, risultati riproducibili e una trasparenza totale sulla metodologia; non attraverso l'ennesimo slide deck in comitato di direzione.
L'importanza di una competenza dedicata
Possedere la governance e costruire questa fiducia è un mestiere a sé stante. Le organizzazioni che scalano i loro programmi di sperimentazione parallela condividono tutte un tratto comune: una funzione dedicata, che possiede la metodologia, le regole di governance e la crescita delle competenze dei team. Da Google o Netflix, è un esercito di specialisti interni, un lusso né realistico né economicamente razionale per la maggior parte delle aziende francesi ed europee.
Welyft struttura e accelera i programmi dei propri clienti per fornire il massimo apprendimento, senza mai compromettere l'affidabilità dei risultati, dall'architettura dei test alla governance del programma, fino alla formazione dei decision maker.
Passa all'azione
Parallelizzare i propri A/B test non è una scommessa temeraria riservata ai giganti della tecnologia con milioni di utenti giornalieri. È lo standard operativo per qualsiasi team digitale serio nel suo percorso di crescita.
La vera sfida non è statistica; lo studio Microsoft e le pratiche dei più grandi sperimentatori lo dimostrano. È organizzativa. I team che si limitano per paura delle interazioni non falliscono perché queste paure si sono verificate. Falliscono perché nessuno possedeva la governance e nessuno aveva costruito la fiducia necessaria per agire su risultati che non «sembrano» puliti.
È esattamente questo tipo di sfida statistica, tecnica e organizzativa che Welyft accompagna quotidianamente presso i team digitali francesi ed europei. Dall'architettura di sperimentazione alla governance dei programmi, passando per la formazione dei decision maker, il nostro approccio è concepito per le realtà del vostro mercato, RGPD incluso.
Volete approfondire prima di lanciarvi? Abbiamo compilato una revisione completa dei quadri statistici, delle architetture e delle pratiche dei migliori team di sperimentazione al mondo, una guida concreta per strutturare il vostro percorso.